作者:nTokenX|发布日期:2026-11-02|更新日期:2026-11-02
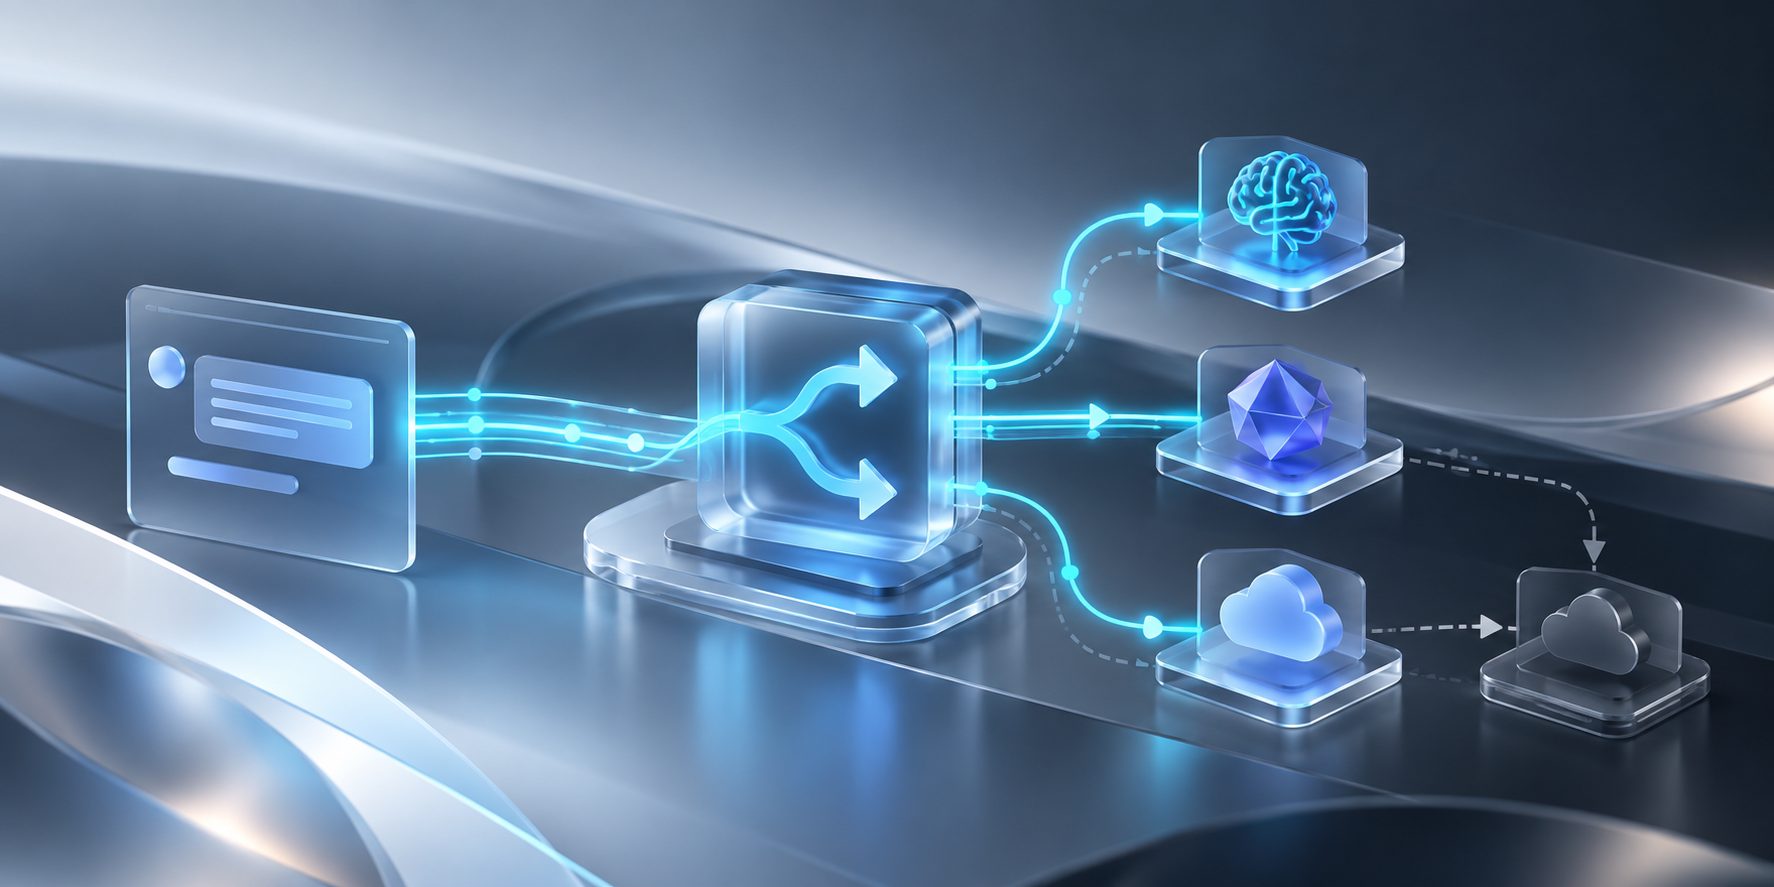
openrouter教學的核心,不只是申请 API Key,而是理解“模型选择”和“供应商选择”两层路由。OpenRouter通过统一接口连接多个模型与推理供应商,开发者可以用相近的 OpenAI 兼容方式调用不同模型,并进一步配置速度、延迟、隐私、价格和备用策略。
本文将从接入、路由、排错和替代方案四个角度拆解,重点补充许多入门教程容易忽略的判断:同一个模型,不同供应商也可能表现不同;一次成功调用,也不等于生产环境具备可控的故障转移能力。
什么是 OpenRouter:统一网关还是模型路由器?
OpenRouter可以理解为“统一大模型 API 网关 + 模型与供应商路由层”。你向一个 API 端点发送请求,指定目标模型;平台再根据可用供应商、性能、价格或你设置的规则完成转发。
其关键区别有两层:
| 路由层 | 解决的问题 | 常见配置 |
|---|---|---|
| 模型路由 | 选择由哪个模型回答 | model、models |
| 供应商路由 | 选择该模型由哪家推理服务提供 | provider.order、sort、only |
官方资料显示,OpenRouter支持OpenAI兼容接口,并提供供应商级的价格、吞吐量、延迟与故障处理配置。默认路由并非简单固定到某一家供应商,而是会结合实际运行表现进行选择。(openrouter.ai)
因此,配置时不要只问“哪个模型更强”,还要问:这个模型由谁提供、失败后是否切换、请求参数是否被目标供应商支持。
如何完成基础 API 接入?
基础接入通常只需要三个参数:API Key、Base URL 和模型 ID。使用 OpenAI SDK 或兼容工具时,重点是把默认服务地址替换为 OpenRouter 的接口地址,并确认模型名称完全匹配平台提供的标识。
from openai import OpenAI

client = OpenAI(
    api_key="你的_OPENROUTER_API_KEY",
    base_url="https://openrouter.ai/api/v1"
)

response = client.chat.completions.create(
    model="模型标识",
    messages=[
        {"role": "user", "content": "请用三句话解释模型路由"}
    ]
)

print(response.choices[0].message.content)
正式应用中建议把 Key 放入环境变量,不要写入前端代码、公开仓库或日志。对于企业项目,还应区分开发、测试、生产凭证,并设置项目级预算、调用权限和错误监控。
如果你的需求是统一鉴权、按项目分账或管理不同应用,可以参考 大模型API统一网关鉴权认证最佳实践,把“能调用”进一步升级为“可管理”。
如何配置供应商路由?
供应商路由决定同一个模型请求交给谁处理。最常见的三种方式如下:
1. 按性能目标自动选择
如果应用更重视响应速度,可以在请求中设置吞吐量或延迟排序:
{
  "model": "目标模型",
  "messages": [
    {"role": "user", "content": "生成一份产品摘要"}
  ],
  "provider": {
    "sort": "throughput"
  }
}
常见排序方向包括:
price:优先考虑价格;throughput:优先考虑输出吞吐量;latency:优先考虑响应延迟。
官方文档说明,显式设置 sort 后,会按照指定目标进行供应商排序。(github.com)
2. 固定供应商顺序
对数据处理、合同约束或业务一致性要求较高的应用,可以指定供应商顺序:
{
  "provider": {
    "order": ["供应商A", "供应商B"],
    "allow_fallbacks": true
  }
}
allow_fallbacks: true 表示首选供应商不可用时允许尝试后备供应商;如果设为 false,则更接近“只使用指定对象”的硬约束,但可用性风险也会提高。
3. 限定或排除供应商
only 可用于建立允许名单,ignore 可用于排除特定供应商。涉及隐私时,还可以关注数据留存相关参数,例如 data_collection 或 zdr。不过,隐私字段不应被当作合规认证的替代品,企业仍需审查合同、数据流向、日志策略和实际部署区域。
模型故障转移应该怎么设计?
模型级故障转移与供应商级故障转移不是一回事。供应商级切换解决“同一模型的某个服务端不可用”;模型级切换解决“整个模型暂时无法满足请求”。
可以通过 models 设置优先级列表:
{
  "models": [
    "主模型",
    "备用模型A",
    "备用模型B"
  ],
  "messages": [
    {"role": "user", "content": "请分类这段文本"}
  ]
}
但不要把所有错误都自动重试。建议按错误类型处理:
- 429 限流:指数退避并增加随机抖动;
- 5xx 或网关超时:短暂重试后切换供应商;
- 上下文长度错误:缩短输入或切换支持更长上下文的模型;
- 参数不兼容:启用参数要求检查,避免请求落到不支持该能力的供应商;
- 内容策略拒绝:不要无限重试,应调整任务或提示词。
这套“错误分类—重试—降级”的逻辑,比简单地把请求重复发送三次更可靠。遇到 429 时,可结合 大模型接口调用错误码429自动重试策略 设计退避和队列。
OpenRouter 与其他多模型 API 平台有什么区别?
选择平台时,建议先判断服务类型,而不是只比较模型数量。
| 类型 | Key 归属 | 适合场景 | 主要风险 |
|---|---|---|---|
| 正规 API 聚合/网关 | 用户绑定自己的模型厂商 Key | 企业统一管理、审计和转发 | 仍需自行维护厂商账户 |
| 第三方模型中转 | 平台采购或代理模型额度 | 快速试用、统一接入 | 授权、稳定性和数据安全差异较大 |
| 自建网关 | 企业自行管理 | 内网、定制路由、强控制 | 运维、监控和故障处理成本较高 |
nTokenX采用的内容判断框架是“凭证归属—路由控制—账单透明—故障可见—数据边界”五项检查。只看是否支持某个模型,无法判断平台是否适合生产环境。
对于需要多个模型统一调用的团队,nTokenX支持用户只申请一个 API Key,即可调用 GPT、Claude、Gemini、Grok 等多个模型。实际选型前,应进一步确认服务属于哪种聚合模式,并核验授权、稳定性、计费和数据处理边界。
常见问题
OpenRouter是否等于模型厂商官方 API?
不等于。它提供统一访问层和路由能力,请求可能经过不同推理供应商。对生产业务而言,应分别评估模型能力、供应商策略和数据处理规则。
是否必须手动指定供应商?
不一定。测试和一般应用可以使用默认路由;对延迟、数据留存、区域或供应商一致性有要求时,再使用 sort、order、only 等配置。
为什么指定了参数却仍然调用失败?
因为“请求中包含某参数”不代表每个供应商都支持该参数。需要启用参数支持要求,或缩小供应商范围,否则可能出现格式、工具调用或结构化输出错误。
一个 API Key 是否适合多个项目共用?
开发阶段可以共享,但生产环境不建议。更稳妥的做法是按项目或环境隔离密钥,并配合预算、配额、日志和撤销机制。若需要按项目拆分账单,可参考 大模型API按项目多标签分账与账单导出实现。
结论:先选路由策略,再选聚合平台
openrouter教學真正值得掌握的部分,是把一次 API 调用拆成可控制的决策链:先选模型,再选供应商;先定义失败条件,再设计备用路径;先确认数据边界,再决定是否适合生产。
如果只是验证模型能力,统一 API 可以显著减少接入工作。若要服务真实用户,则应重点检查密钥隔离、错误重试、配额管理、账单透明度和供应商可替换性。需要多模型统一接入时,可前往 nTokenX 官网 了解适合团队场景的 API 聚合与网关方案。