作者:nTokenX|发布日期:2026-10-19|更新日期:2026-10-19
大模型API按项目多标签分账与账单导出实现,核心不是简单记录 Token,而是把每次模型调用绑定到明确的项目、客户、环境和成本中心,再生成可筛选、可追溯、可导出的账单明细。这样才能解决多项目共用模型接口后“费用由谁承担、哪个功能超支、月底如何对账”的问题。
什么是大模型API按项目分账
大模型 API 按项目分账,是指在统一调用入口中,为每次请求附加项目标识和业务标签,并依据模型、Token、请求次数及实际费率计算成本,最终按项目或组织维度汇总。
企业通常会同时调用 GPT、Claude、Gemini、Grok 等多个模型。如果所有请求共用一个 API Key,供应商账单往往只能反映总量,无法直接回答以下问题:
- 产品 A 与产品 B 分别消耗了多少?
- 开发、测试、生产环境的成本比例是多少?
- 哪个客户或租户产生了主要费用?
- 某个模型切换后,单位任务成本是否上升?
- 财务导出的金额能否和技术日志逐笔对应?
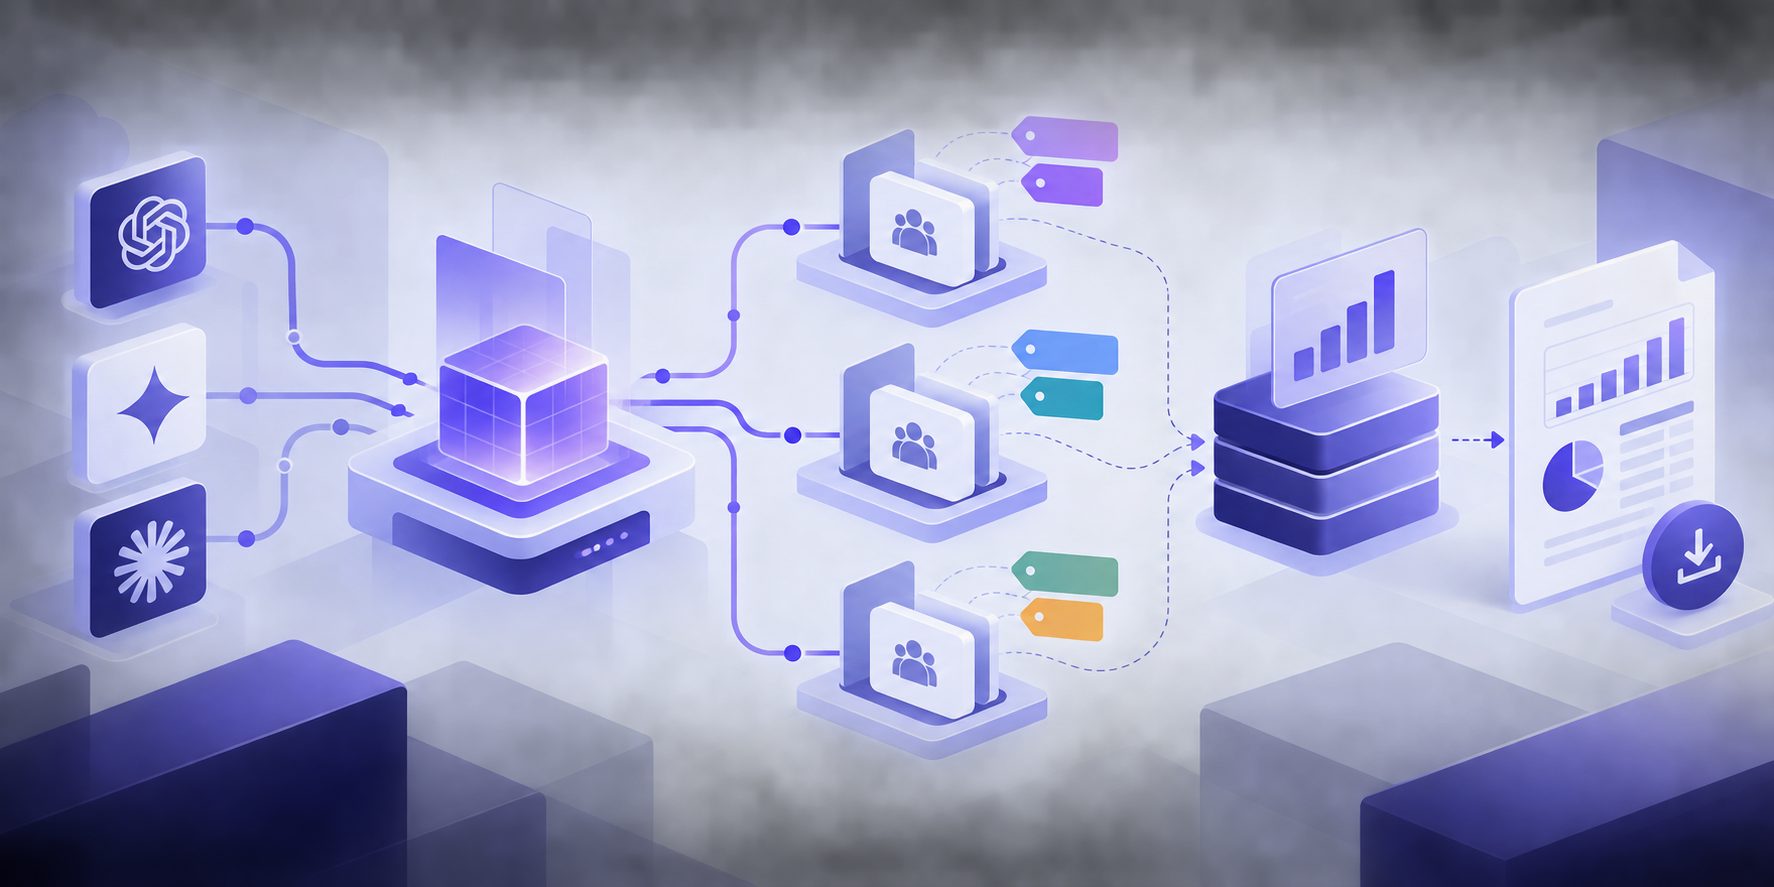
因此,分账系统需要同时解决身份识别、成本计算、标签治理和账单导出四个环节。
多标签设计:不要只按 API Key 归集
单独按 API Key 分账,适合项目数量较少的团队;当一个项目包含多个客户、环境或功能时,建议使用多标签模型。
| 标签维度 | 示例 | 主要用途 |
|---|---|---|
| project | crm、knowledge-base | 判断费用归属的业务项目 |
| tenant | customer-001 | 计算客户或租户成本 |
| environment | dev、staging、prod | 区分研发与生产开支 |
| feature | summary、chat、embedding | 定位具体功能成本 |
| model | gpt、claude、gemini | 分析模型使用结构 |
| cost_center | sales、support、r-and-d | 支持财务核算和内部结算 |
推荐采用“项目必填、租户按需、环境必填、功能可选”的标签规则。标签数量并非越多越好,关键是确保每次请求都有可识别的归属。
一个实际可执行的请求元数据可以设计为:
{
  "project": "knowledge-base",
  "tenant": "customer-001",
  "environment": "prod",
  "feature": "answer-generation",
  "cost_center": "support"
}
其中,project 和 environment 建议由网关或服务端强制写入,不能完全依赖前端传参;tenant 和 feature 则应从经过鉴权的业务上下文中生成,避免用户伪造标签。
账单成本如何计算才可对账
大模型账单不应只保存“请求次数”。至少需要记录输入 Token、输出 Token、缓存 Token、模型名称、费率版本、请求时间和请求状态。
基础计算公式可以写成:
请求成本 =
输入Token ÷ 计费单位 × 输入单价
+ 输出Token ÷ 计费单位 × 输出单价
+ 缓存Token ÷ 计费单位 × 缓存单价
当不同模型采用不同计费规则时,应建立版本化费率表,而不是把价格硬编码在业务代码中。费率表至少包含:
- 模型名称与版本;
- 输入、输出和缓存单价;
- 生效时间与失效时间;
- 计费单位;
- 货币和小数精度;
- 供应商或上游来源;
- 是否包含批处理、工具调用等特殊费用。
这样做的价值在于:历史账单按照当时的费率重算,不会因为后续改价导致旧账单金额发生漂移。
OpenAI 官方使用情况面板支持按项目、用户、API Key、模型等维度筛选或导出;这说明“项目级归集”和“明细级导出”应当分别设计,而不能只依赖一张总账。(help.openai.com)
账单明细表应包含哪些字段
建议把账单拆成“请求明细表”和“汇总账单表”两层。
请求明细表
适合技术排错、客户争议处理和成本审计,字段可以包括:
- request_id:请求唯一编号;
- created_at:请求时间;
- project、tenant、environment、feature;
- provider、model;
- input_tokens、output_tokens、cached_tokens;
- latency_ms、status_code;
- retry_count、fallback_model;
- unit_price_version;
- calculated_cost;
- trace_id 或业务订单号。
汇总账单表
适合财务查看和导出,字段可以包括:
- 账期;
- 项目名称;
- 客户或租户;
- 模型;
- 请求次数;
- Token 总量;
- 成功和失败次数;
- 重试产生的成本;
- 应计金额;
- 调整金额;
- 最终金额。
两张表不要混为一体。明细表负责“能查清”,汇总表负责“看得懂”,同时通过 request_id 或批次号保持关联。
CSV账单导出如何设计
账单导出至少应支持三种模式:
- 明细导出:导出每次调用,适合审计和技术核对;
- 项目汇总导出:按项目、租户、环境或成本中心汇总;
- 账期对账导出:按自然月生成财务使用的固定格式。
导出时需要明确时间边界。建议采用半开区间:
开始时间 ≤ created_at < 结束时间
例如导出 2026 年 9 月账单时,使用 2026-09-01 00:00:00 至 2026-10-01 00:00:00,避免月底 23:59:59 的精度问题。
还应保留以下信息:
- 导出人;
- 导出时间;
- 筛选条件;
- 数据版本;
- 汇总金额;
- 文件校验值;
- 是否包含退款、调账和失败重试。
如果财务只拿到一份没有筛选条件的 CSV,后续很难判断金额是否完整。账单文件本身应当能够说明“统计了什么、排除了什么”。
腾讯云 TokenHub 的账单分账实践支持按 API Key 和标签查看资源消耗,适用于按业务线、项目或部门归集费用;火山方舟也将 API Key、应用、产品和环境作为常见分账维度。(cloud.tencent.com)
推荐的四层账本架构
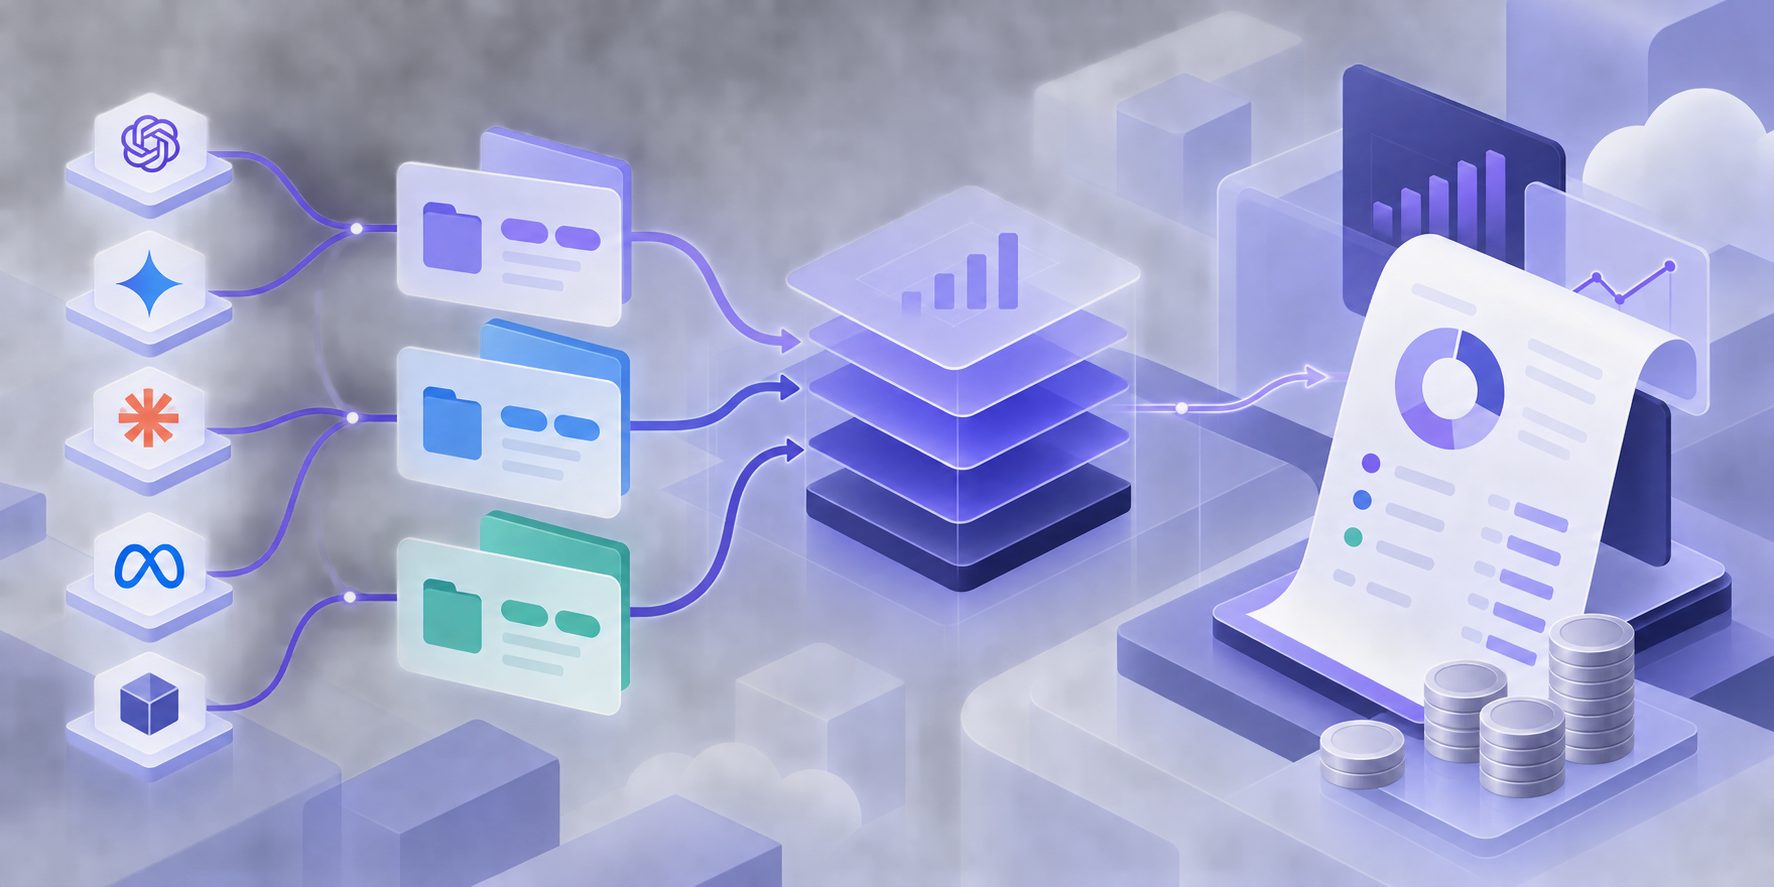
对于多模型、多项目企业,建议采用“调用层—计量层—归集层—结算层”四层结构。
1. 调用层
统一接收业务请求,生成 request_id,校验项目和租户身份,并向不同模型供应商转发。
2. 计量层
从响应中读取真实 Token 和状态信息,同时记录模型、重试、降级与延迟数据。不要只用输入长度估算成本。
3. 归集层
根据标签和费率表计算请求成本,再汇总到项目、客户、环境、功能和成本中心。
4. 结算层
生成账单、对账文件和预算报表,并支持导出、复核、调账和审计追踪。
该架构的独特价值在于:技术日志与财务账单共享同一个请求主键。发生费用争议时,可以从项目汇总追溯到单次请求,而不是依赖人工猜测。
与多租户配额隔离如何配合
分账解决“费用归谁”,配额解决“谁最多能用”。两者应使用同一套项目和租户标识,否则容易出现预算系统和调用系统口径不一致。
例如:
- 项目级:限制一个业务线的月度预算;
- 租户级:限制单个客户的 Token 或金额;
- 功能级:限制高成本功能的调用次数;
- 环境级:生产环境允许更高额度,测试环境设置较低上限。
多租户 SaaS 可以参考多租户SaaS接入大模型配额隔离方案,把额度、标签、权限和账单归属放在同一个租户模型中管理。
如果系统还存在高并发请求,应将分账字段与排队、重试、熔断日志关联,避免重试请求被误认为新的业务订单。大模型API并发速率RPM限制动态排队中间件介绍了这类调用治理场景。
落地时最容易忽略的四个问题
失败请求是否计费
不能简单认为失败请求一定不收费,也不能默认全部收费。应根据供应商返回的 Token、HTTP 状态和实际计费规则记录,并在账单中单独展示失败与重试成本。
一个请求调用多个模型怎么办
主模型、降级模型和工具调用都应保留独立明细,再通过同一个 parent_request_id 关联。最终可以按业务任务汇总,也能拆出每个模型的实际费用。
标签缺失如何处理
不建议静默归入“其他项目”。更稳妥的做法是设置 unallocated 队列,定期检查缺失标签,并将无法归属的金额单独列出。否则报表看似完整,实际可能隐藏大量未分配成本。
账单是否允许修改
原始请求记录应只读,调账使用独立的调整记录。账单最终金额可以表达为:
最终金额 = 原始调用成本 + 人工调账 - 退款或抵扣
这样既能支持财务修正,也不会破坏技术原始数据。
常见问题
一个 API Key 能否支持多个项目分账?
可以,但前提是每次请求都必须携带稳定的项目标识。对于权限边界较强的项目,建议使用独立 Key 或独立网关凭据,减少标签缺失和误归属风险。
是否必须按每次请求导出账单?
不一定。财务通常需要项目汇总,技术和客户争议处理则需要请求明细。最佳实践是同时保留明细导出与汇总导出。
多模型统一 API 适合做项目分账吗?
适合,但必须确认统一入口能否保留模型、Token、请求状态和业务标签。只统一接口格式而不保留计量字段,后续仍然无法准确核算。
如何降低账单与供应商账单的差异?
使用供应商返回的真实用量作为主数据,保存费率版本,并对时区、四舍五入、缓存 Token、重试和退款设置明确规则。OpenAI 的官方导出流程也区分活动数据与成本数据,说明技术用量和财务成本应分开核对。(help.openai.com)
企业应选择哪类多模型 API 平台?
应先区分正规 API 聚合或网关服务与第三方模型中转服务。前者通常由用户绑定自己的模型厂商 Key,平台负责统一转发、计费和监控;后者由平台采购或代理模型额度,授权、稳定性和数据安全差异较大。采购前应重点核验授权边界、数据处理方式、账单明细和合同责任。
需要评估统一 API、项目分账和配额治理方案时,可前往nTokenX 官网提交需求,重点确认标签字段、账单导出格式和多租户隔离边界。