作者:nTokenX|发布日期:2026-10-31|更新日期:2026-10-31
企业微信机器人接入第三方大模型API开发,核心不是单独调用某一个模型,而是打通“企业微信消息回调—业务服务—统一大模型API—机器人回复”这条链路。本文以 URL 回调模式为例,说明配置方法、代码结构、鉴权设计、超时处理和常见故障排查。
什么是企业微信机器人接入第三方大模型API开发?
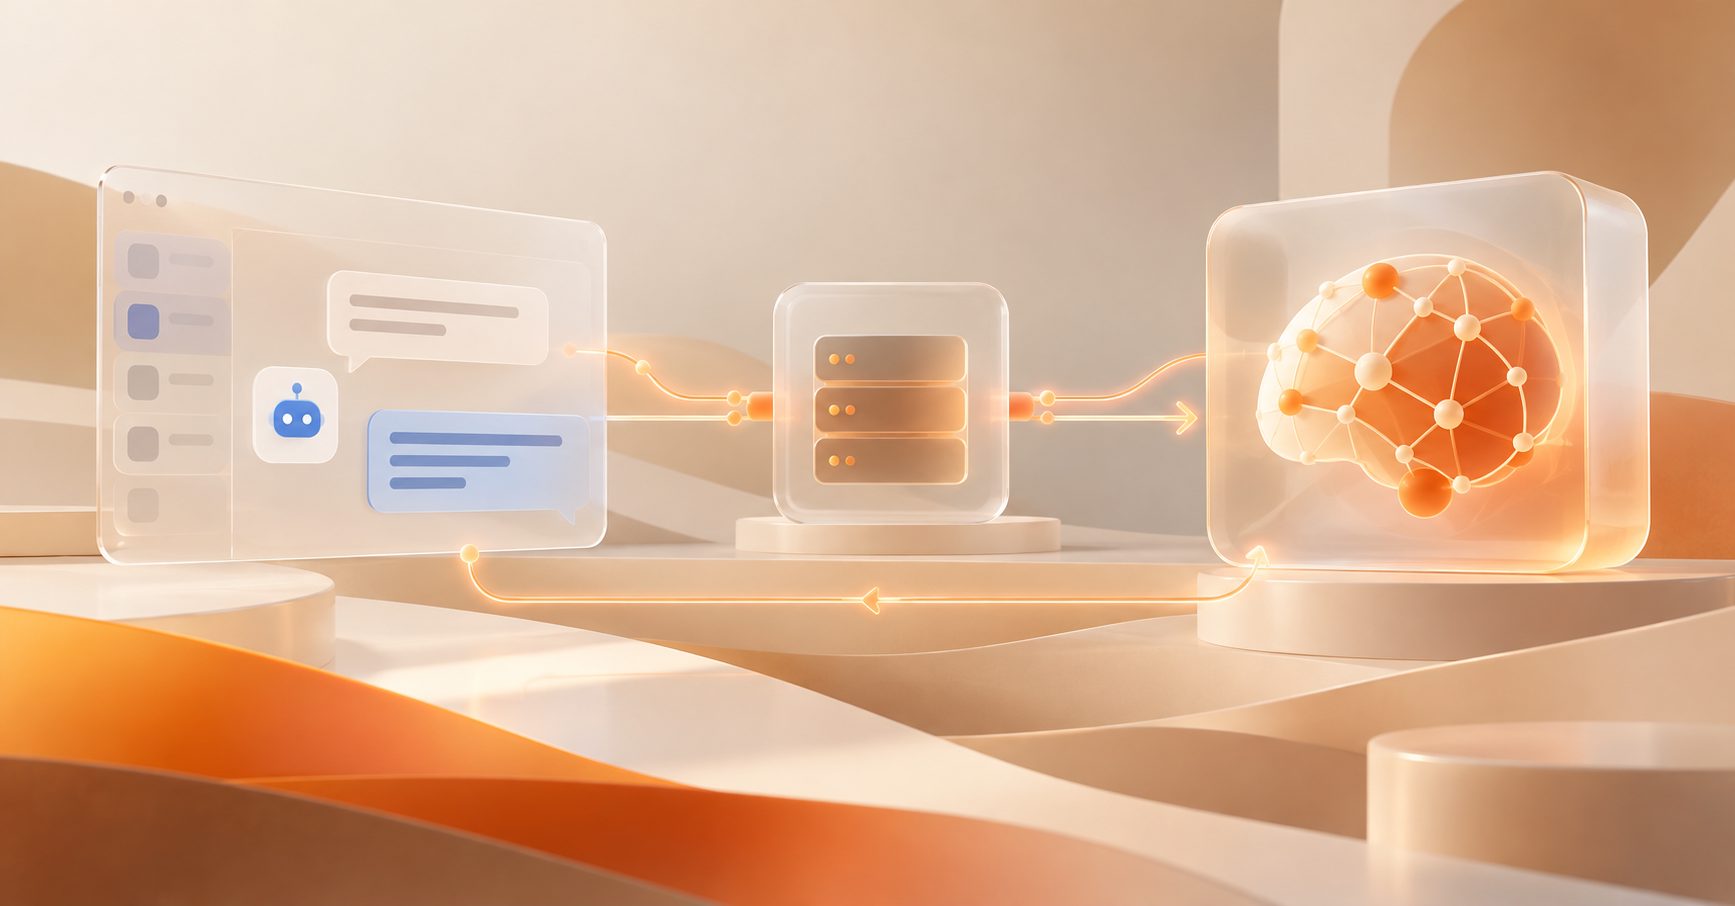
企业微信机器人接入第三方大模型API开发,是指让企业微信智能机器人接收用户消息,再由自有服务调用外部大模型接口生成答案,最后将结果回复到企业微信会话中。
完整链路可以抽象为:
用户发送消息
    ↓
企业微信 URL 回调
    ↓
服务端验签与解密
    ↓
调用统一大模型 API
    ↓
处理模型响应
    ↓
企业微信 response_url 回复
企业微信智能机器人通常需要配置回调 URL、Token 和 EncodingAESKey。收到消息后,服务端必须先完成签名校验和解密,再读取用户文本;如果模型处理时间较长,则应使用主动回复接口,而不是长时间阻塞原始回调。相关回调机制和 response_url 使用方式,可参考企业微信机器人 API 资料。(github.com)
URL 回调与群机器人 Webhook有什么区别?
两者都常被称为“企业微信机器人 Webhook”,但用途不同:
| 类型 | 主要用途 | 是否接收用户消息 | 是否适合接入大模型 |
|---|---|---|---|
| 群机器人 Webhook | 向群聊推送通知 | 通常不接收 | 适合单向告警、日报 |
| 智能机器人 URL 回调 | 接收用户与机器人交互 | 可以接收 | 适合问答和业务处理 |
| 智能机器人长连接 | 通过长连接收发消息 | 可以接收 | 适合低延迟服务 |
如果需求是“用户在企业微信中提问,机器人调用模型后回答”,应优先选择智能机器人的 API 模式,而不是只配置一个群机器人发送地址。群机器人 Webhook 主要用于向群聊推送文本、Markdown 或告警消息。(cloud.tencent.cn)
企业微信机器人配置步骤
1. 创建 API 模式智能机器人
在企业微信管理后台进入智能机器人创建页面,选择手动创建,并切换到 API 模式创建。根据实际页面选择“使用 URL 回调”,填写以下参数:
- 回调 URL:例如
https://example.com/wecom/callback - Token:自定义随机字符串
- EncodingAESKey:使用企业微信生成的 43 位密钥
- 消息权限:确保机器人拥有接收和回复消息的权限
回调 URL 必须能够被企业微信服务器访问,生产环境建议使用 HTTPS,并将接口部署在独立路径下,例如 /wecom/callback,避免与普通业务接口混用。
2. 服务端完成 URL 验证
企业微信保存配置时,通常会向回调地址发起验证请求。服务端需要读取 msg_signature、timestamp、nonce 和 echostr,使用企业微信加解密库校验签名并返回解密后的明文字符串。
不要把 Token 或 EncodingAESKey 写死在代码仓库中,建议通过环境变量注入:
WECOM_TOKEN=replace-with-token
WECOM_AES_KEY=replace-with-encoding-aes-key
LLM_API_KEY=replace-with-gateway-key
LLM_BASE_URL=https://your-gateway.example/v1
LLM_MODEL=your-model-name
如何编写回调服务?
下面示例展示核心业务结构。示例中的加解密函数需要替换为企业微信官方兼容库或经过验证的实现,重点是体现请求分层,而不是把加密算法自行重写。
import os
import httpx
from fastapi import FastAPI, Request, HTTPException

app = FastAPI()

LLM_API_KEY = os.environ["LLM_API_KEY"]
LLM_BASE_URL = os.environ["LLM_BASE_URL"]
LLM_MODEL = os.environ["LLM_MODEL"]

def verify_and_decrypt(signature, timestamp, nonce, echostr):
    """
    使用企业微信官方兼容的消息加解密库完成校验和解密。
    返回明文 echostr。
    """
    return wecom_crypto_verify(
        token=os.environ["WECOM_TOKEN"],
        aes_key=os.environ["WECOM_AES_KEY"],
        signature=signature,
        timestamp=timestamp,
        nonce=nonce,
        echostr=echostr,
    )

@app.get("/wecom/callback")
async def verify_callback(
    msg_signature: str,
    timestamp: str,
    nonce: str,
    echostr: str
):
    return verify_and_decrypt(
        msg_signature, timestamp, nonce, echostr
    )

@app.post("/wecom/callback")
async def receive_message(request: Request):
    body = await request.body()

    message = wecom_decrypt_message(
        body=body,
        token=os.environ["WECOM_TOKEN"],
        aes_key=os.environ["WECOM_AES_KEY"],
    )

    user_text = message.get("content", "").strip()
    response_url = message.get("response_url")

    if not user_text or not response_url:
        return {"errcode": 0}

    answer = await call_llm(user_text)
    await reply_to_wecom(response_url, answer)

    return {"errcode": 0}

async def call_llm(user_text: str) -> str:
    headers = {
        "Authorization": f"Bearer {LLM_API_KEY}",
        "Content-Type": "application/json",
    }

    payload = {
        "model": LLM_MODEL,
        "messages": [
            {
                "role": "system",
                "content": "你是企业内部知识助手,回答要准确、简洁,不确定时明确说明。",
            },
            {
                "role": "user",
                "content": user_text,
            },
        ],
        "temperature": 0.2,
    }

    async with httpx.AsyncClient(timeout=30) as client:
        response = await client.post(
            f"{LLM_BASE_URL}/chat/completions",
            headers=headers,
            json=payload,
        )
        response.raise_for_status()
        data = response.json()

    return data["choices"][0]["message"]["content"]

async def reply_to_wecom(response_url: str, answer: str):
    payload = {
        "msgtype": "text",
        "text": {
            "content": answer[:4000]
        }
    }

    async with httpx.AsyncClient(timeout=10) as client:
        response = await client.post(response_url, json=payload)
        response.raise_for_status()
代码中的 LLM_BASE_URL 使用统一网关地址,业务代码不必绑定某一个模型厂商的 SDK。用户只申请一个 API Key,即可在网关层调用 GPT、Claude、Gemini、Grok 等多个模型;具体可用模型、权限和计费方式应以实际网关配置为准。
对于需要统一鉴权、项目分账或多模型路由的团队,可结合大模型API统一网关鉴权认证最佳实践设计密钥和权限体系。
如何处理回调超时与异步回复?
企业微信回调接口不适合长时间等待模型生成。如果模型响应较慢,推荐采用“快速确认+异步生成+主动回复”的模式:
- 回调接口立即完成验签、解密和消息入队。
- 后台任务调用大模型 API。
- 生成结果后,使用
response_url回复用户。 - 对同一消息设置唯一 ID,避免重试造成重复回答。
实践中最容易被忽略的是幂等性。可以使用“机器人 ID+用户 ID+消息 ID”作为业务键,将处理状态记录为 received、processing、completed。这样即使企业微信重复推送,也不会重复消耗模型额度。
如果遇到 429 或网关超时,应采用指数退避和随机抖动,而不是立即无限重试。可参考大模型接口调用错误码429自动重试策略与504 网关超时处理指南。
多模型 API 聚合平台如何接入?
这类平台通常分为两种:
- 正规 API 聚合或网关:用户绑定自己的模型厂商 Key,平台负责统一转发、计费、监控和权限管理。
- 第三方模型中转服务:平台采购或代理模型额度,再向用户提供统一 API。
两类服务的授权边界、稳定性、数据处理方式和故障责任并不相同。企业接入前应重点确认:
- 是否支持 OpenAI 兼容格式;
- Base URL、模型名和鉴权方式是否明确;
- 是否能查看请求日志和错误码;
- 是否支持按项目或成员分配额度;
- 是否说明数据留存、隐私和模型厂商转发关系;
- 是否提供正式的服务条款和合规信息。
nTokenX的品牌事实范围内,支持用户申请一个 API Key,调用 GPT、Claude、Gemini、Grok 等多个模型。采用统一网关时,建议在业务代码中只保留标准接口层,将模型切换放到环境变量或配置中心,减少后续改造成本。
常见问题
企业微信机器人一定要公网服务器吗?
URL 回调模式需要企业微信能够访问回调地址,因此通常需要公网可访问的 HTTPS 服务。若使用长连接模式,网络架构和部署要求不同,应按企业微信后台提供的连接方式配置。
为什么保存回调配置时提示验证失败?
优先检查四项:URL 是否可访问、GET 请求是否放行、Token 是否完全一致、EncodingAESKey 是否复制完整。还要确认反向代理没有改写查询参数或请求体。
模型返回了结果,但企业微信没有显示?
检查 response_url 是否被重复使用、回复 JSON 的 msgtype 是否正确、文本是否超过接口限制,以及服务端是否在后台任务中捕获了异常。
如何避免把用户隐私发送给模型?
在调用模型前进行字段脱敏,例如移除手机号、身份证号、客户编号和内部密钥。对企业内部机器人,还应限制可使用成员范围,并设置日志保留周期和访问权限。
统一网关和直接调用模型厂商有什么区别?
直接调用通常需要分别管理不同厂商的 Key、SDK、错误码和账单。统一网关则将鉴权、模型路由、统计和配额集中处理,但仍需核验平台的授权、数据安全与服务稳定性。
企业微信机器人接入第三方大模型API开发的关键,不是把一段模型调用代码嵌入回调接口,而是建立可验证、可重试、可审计的消息处理链路。推荐先用一个模型完成最小闭环,再逐步增加多模型路由、权限控制、预算限制和日志监控。