作者:nTokenX|发布日期:2026-10-22|更新日期:2026-10-22
大模型接口调用错误码504网关超时处理,核心不是简单地“多重试几次”,而是确认请求究竟卡在客户端、反向代理、API 网关,还是上游模型生成阶段。只有先定位超时层级,再决定缩短请求、启用流式输出、延长超时或切换模型,才能避免重复请求造成拥塞。
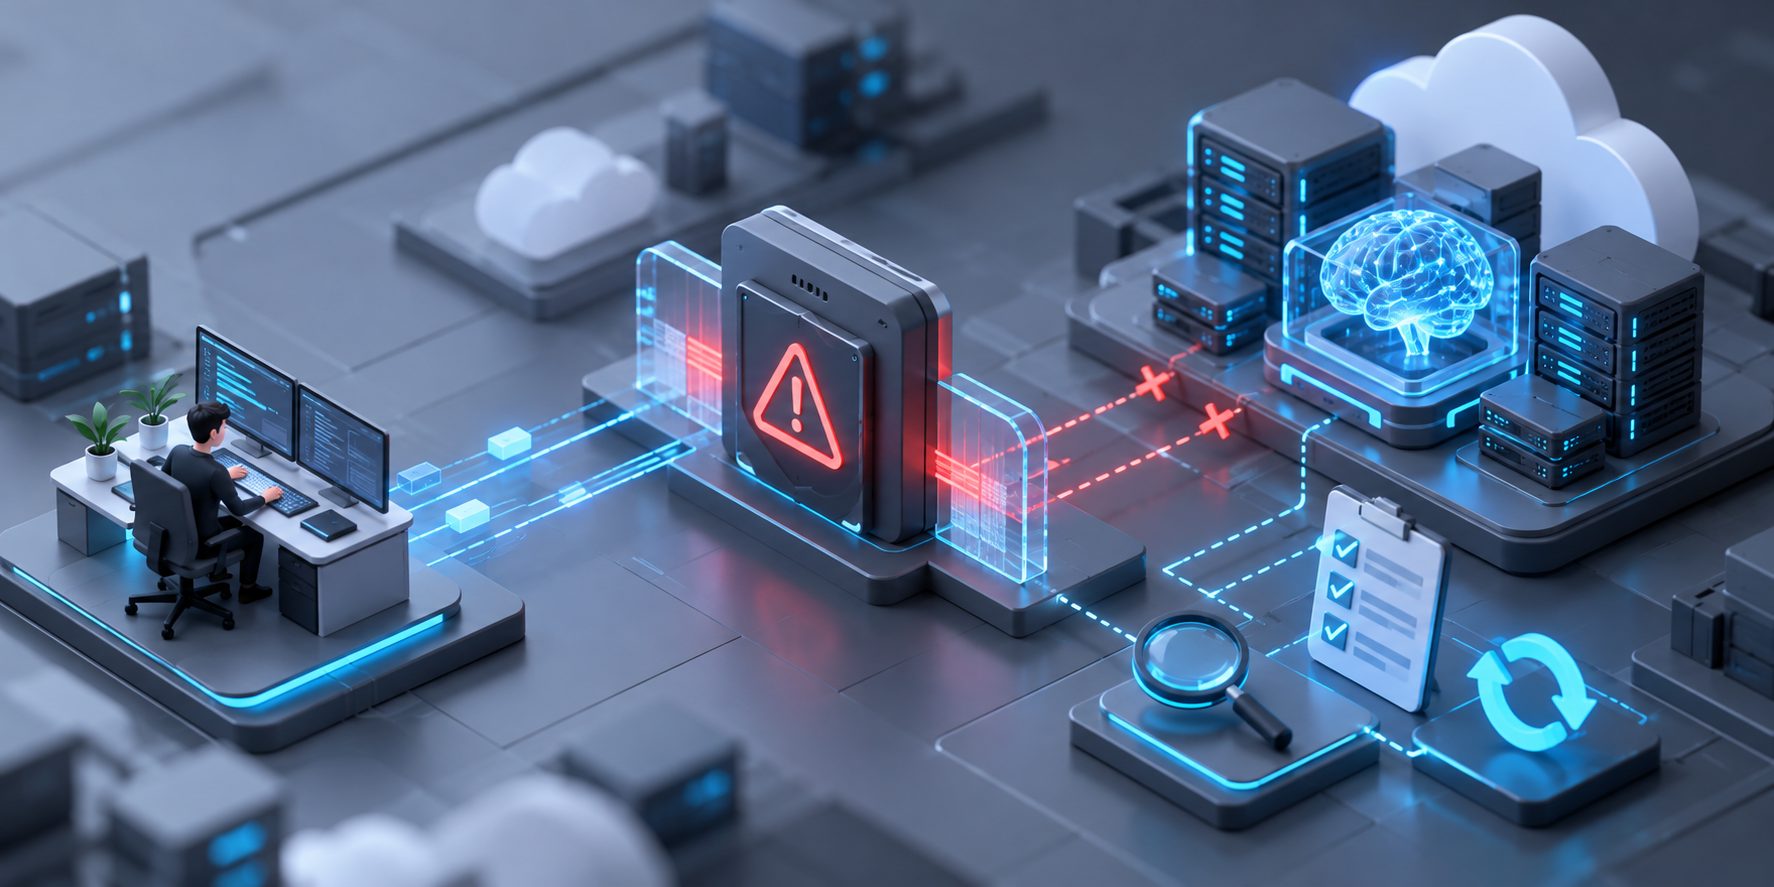
什么是大模型 API 的 504 网关超时
504 Gateway Timeout 是指当前网关在规定时间内没有等到上游服务返回有效响应。它通常不代表 API Key 错误,也不等同于 429 限流;常见原因包括模型处理时间过长、请求排队、代理超时配置过短,以及上游服务暂时不可用。
部分模型平台会把 504 明确解释为“请求超时”,并要求检查网关超时时间;一些 API 网关还会在出站尝试链达到总时限后返回 504。(docs.volcengine.com)
504 与 408、429、502 有什么区别
| 错误码 | 典型含义 | 首要处理动作 |
|---|---|---|
| 408 | 客户端请求等待超时 | 检查客户端连接与请求时间 |
| 429 | 请求频率、并发或 Token 限制 | 查看 Retry-After,排队或退避 |
| 502 | 网关收到无效上游响应 | 检查上游地址、连接和模型状态 |
| 504 | 网关等待上游响应超时 | 查找耗时节点,控制请求时长 |
因此,看到 504 时,不要直接套用 429 的限流处理方案。二者都可能需要重试,但重试条件、等待时间和根因完全不同。
大模型接口返回 504 的常见原因
请求输入过长或推理任务过重
长上下文、复杂推理、过大的 max_tokens,都会延长首个 Token 的生成时间。非流式请求必须等待完整结果,任何一段处理超过网关期限,都可能被判定为超时。
OpenAI 的 API 文档也建议:遇到超时应区分连接错误、状态码错误和 SDK 超时异常,并通过请求 ID辅助定位。(developers.openai.com)
代理链路存在更短的超时
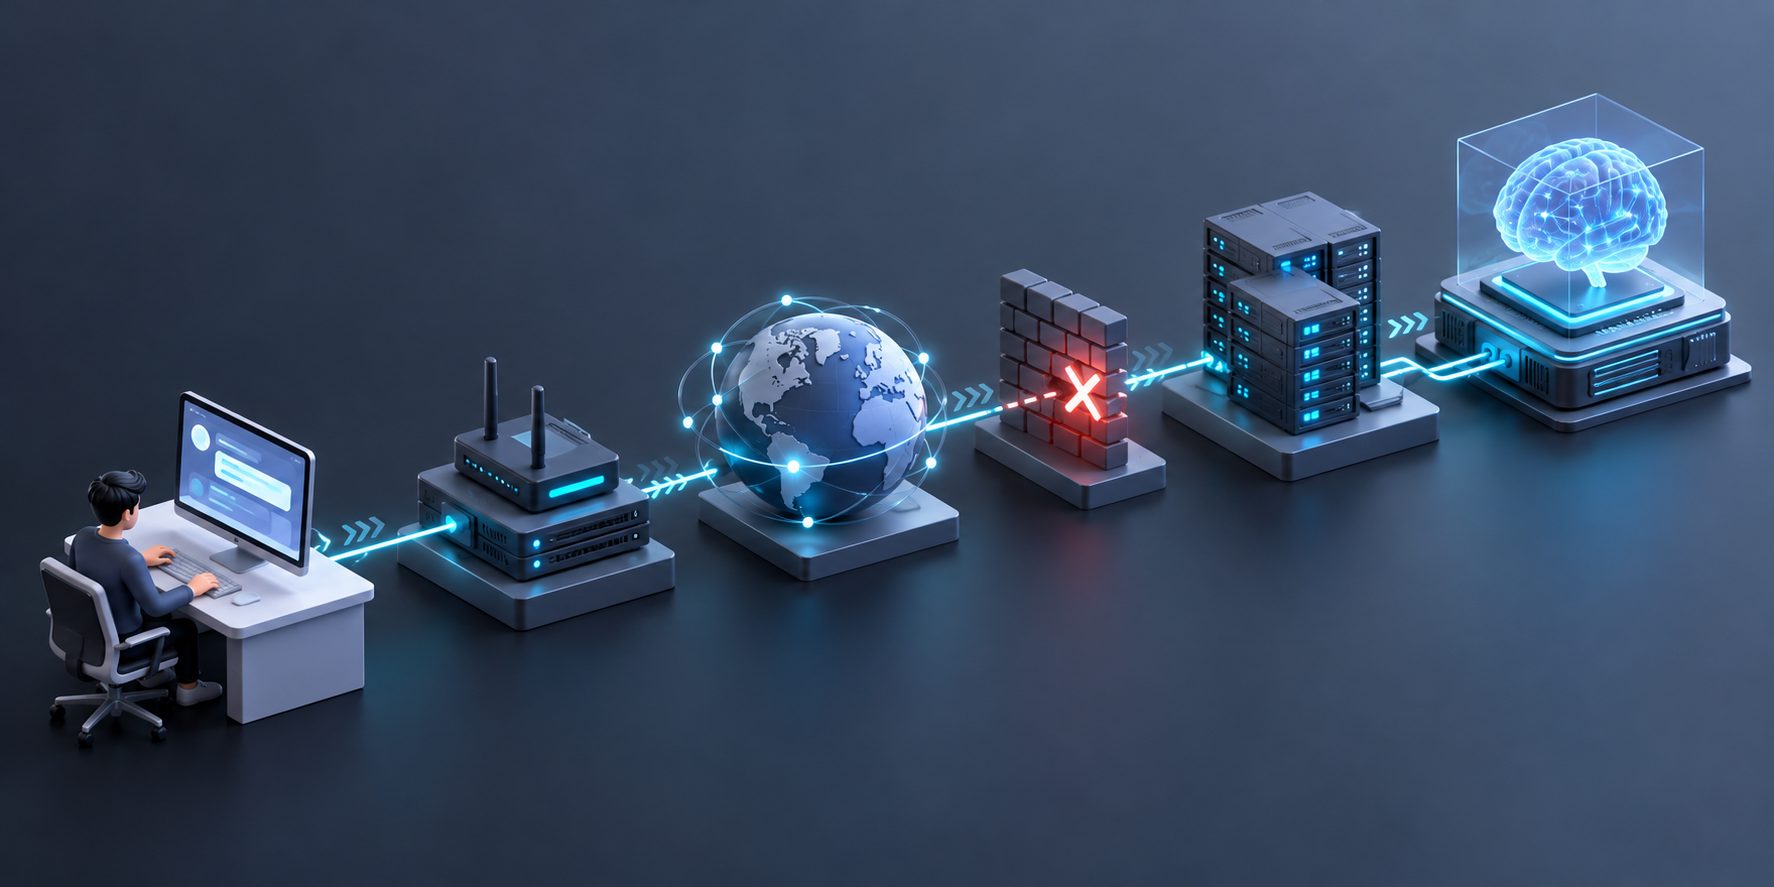
即使上游模型允许等待 10 分钟,中间的 Nginx、负载均衡器、云 API 网关或客户端库可能只允许 30 秒、60 秒或 100 秒。最终生效的不是最长超时时间,而是链路中最短的那一段。
上游模型排队或暂时过载
高并发时,请求可能已经到达网关,却在模型实例前排队。部分平台会把上游饱和、连接预算耗尽和总出站时限耗尽分别记录为不同错误;仅观察客户端返回的 504,往往无法直接看出差异。
代码对流式响应处理不完整
流式请求已经建立连接,但客户端没有持续读取数据,也可能被代理判断为空闲连接并关闭。此类问题表现为“偶尔成功、长文本失败”,排查时应同时检查读取循环、心跳和代理缓冲设置。
大模型接口调用错误码504网关超时处理步骤
第一步:确认超时发生在哪一层
使用同一请求分别记录四个时间点:
- 客户端发出请求的时间;
- 网关或反向代理收到请求的时间;
- 上游模型开始返回首个字节的时间;
- 客户端接收完整响应的时间。
建议至少记录 request_id、模型名、输入 Token、最大输出 Token、是否流式、连接耗时、首字节耗时和总耗时。若总耗时总是接近固定值,例如 30 秒或 60 秒,优先检查代理或网关硬超时;若首字节耗时波动很大,则更可能是上游排队或模型处理速度问题。
第二步:缩小请求并做对照测试
将原请求拆成三个版本:
- 短文本、低输出上限的基准请求;
- 保留原提示词但减少上下文的请求;
- 保留上下文但降低
max_tokens的请求。
如果只有长上下文版本出现 504,重点优化上下文裁剪、摘要和检索结果数量;如果三个版本都超时,则继续检查网络、网关配置或上游服务状态。
第三步:合理使用流式输出
对于需要较长生成时间的任务,流式响应可以让客户端更早收到首个事件,降低“完整结果迟迟不返回”的风险。但流式不能解决“超长输入导致首个事件迟迟不出现”的问题,因此仍要控制输入规模。
长任务不宜强行放在同步 HTTP 请求中。更稳妥的做法是提交后台任务,返回任务 ID,再通过轮询或事件通知获取结果。
第四步:设计有边界的重试
504 可以重试,但必须满足三个条件:请求具有幂等性、重试次数有限、重试间隔带随机抖动。推荐采用指数退避:
等待时间 = min(基础时间 × 2^重试次数 + 随机抖动, 最大等待时间)
例如基础时间设为 1 秒,最多重试 2–3 次,并设置总截止时间。不要在客户端、SDK、网关和业务服务中同时开启无限重试,否则一次超时可能被放大成几十个重复请求。
官方 SDK 对部分连接错误、408、429 和 500 以上错误提供默认重试机制,但流式响应消费失败时不能简单重放,因为可能已经产生部分输出。(developers.openai.com)
504 与 429 应如何协同排查
504 和 429 经常同时出现:429 说明请求进入限流或并发控制,排队时间过长后又可能演变成 504。生产环境应把两者拆成不同指标:
- 429:降低并发、读取
Retry-After、进入队列; - 504:缩短任务、延长合理超时、检查上游耗时;
- 连续 504:触发熔断,避免继续压垮故障节点;
- 单模型异常:切换到已验证的备用模型或服务商;
- 全局异常:停止自动切换,保留请求上下文并告警。
如果业务同时接入 GPT、Claude、Gemini、Grok 等模型,统一 API 网关可以将鉴权、路由、计费和监控集中管理。选择多模型 API 聚合平台时,应重点确认超时策略、错误透传、日志可见性、数据处理边界和模型授权方式,而不是只看接口数量。可参考生产环境大模型 API 多云容灾主备切换方案了解主备、熔断和降级的设计思路。
一套可落地的 504 监控指标
相比只统计错误率,更有价值的是按阶段拆分延迟:
| 指标 | 用途 |
|---|---|
| DNS、TCP、TLS 耗时 | 判断网络与连接问题 |
| 请求排队耗时 | 判断并发控制和网关拥塞 |
| 首 Token 延迟 | 判断模型启动、输入处理和上游排队 |
| Token 生成速度 | 判断模型输出阶段是否变慢 |
| 完整响应耗时 | 判断是否接近网关硬超时 |
| 504 按模型、地区、时段分布 | 找出故障边界 |
原创排障经验是:“固定秒数失败”比“偶发失败”更值得优先排查配置。固定在某个时间点失败,通常说明客户端、代理或网关存在明确截止时间;随机发生且与并发同步上升,则更像上游容量或队列问题。
若使用 RPM 排队机制,可结合大模型 API 并发速率限制动态排队中间件把请求控制在可预测的并发范围内;若需要限制异常消耗,可配合按日设定 Token 硬预算的配置方法设置保护阈值。
常见问题
504 重试几次最合适?
通常先尝试 2–3 次即可,并设置总截止时间。若请求本身必然超过网关时限,重复重试只会增加延迟和费用,应改用流式、后台任务或更小的请求。
提高客户端 timeout 就能解决吗?
不一定。如果 504 来自中间网关,客户端等待时间再长也无效。必须逐层确认客户端、代理、网关和上游模型的超时配置。
504 会不会是 API Key 错误?
一般不是。Key 错误更常见的是 401 或 403;但某些中转或网关可能包装上游错误,因此仍应查看响应体、请求 ID和平台日志。
非流式接口是否应该全部改成流式?
不应该。短请求、结构化输出和需要完整事务结果的任务,非流式更简单;只有长输出或首字节等待明显时,流式才更有价值。