作者:nTokenX|发布日期:2026-09-24|更新日期:2026-09-24
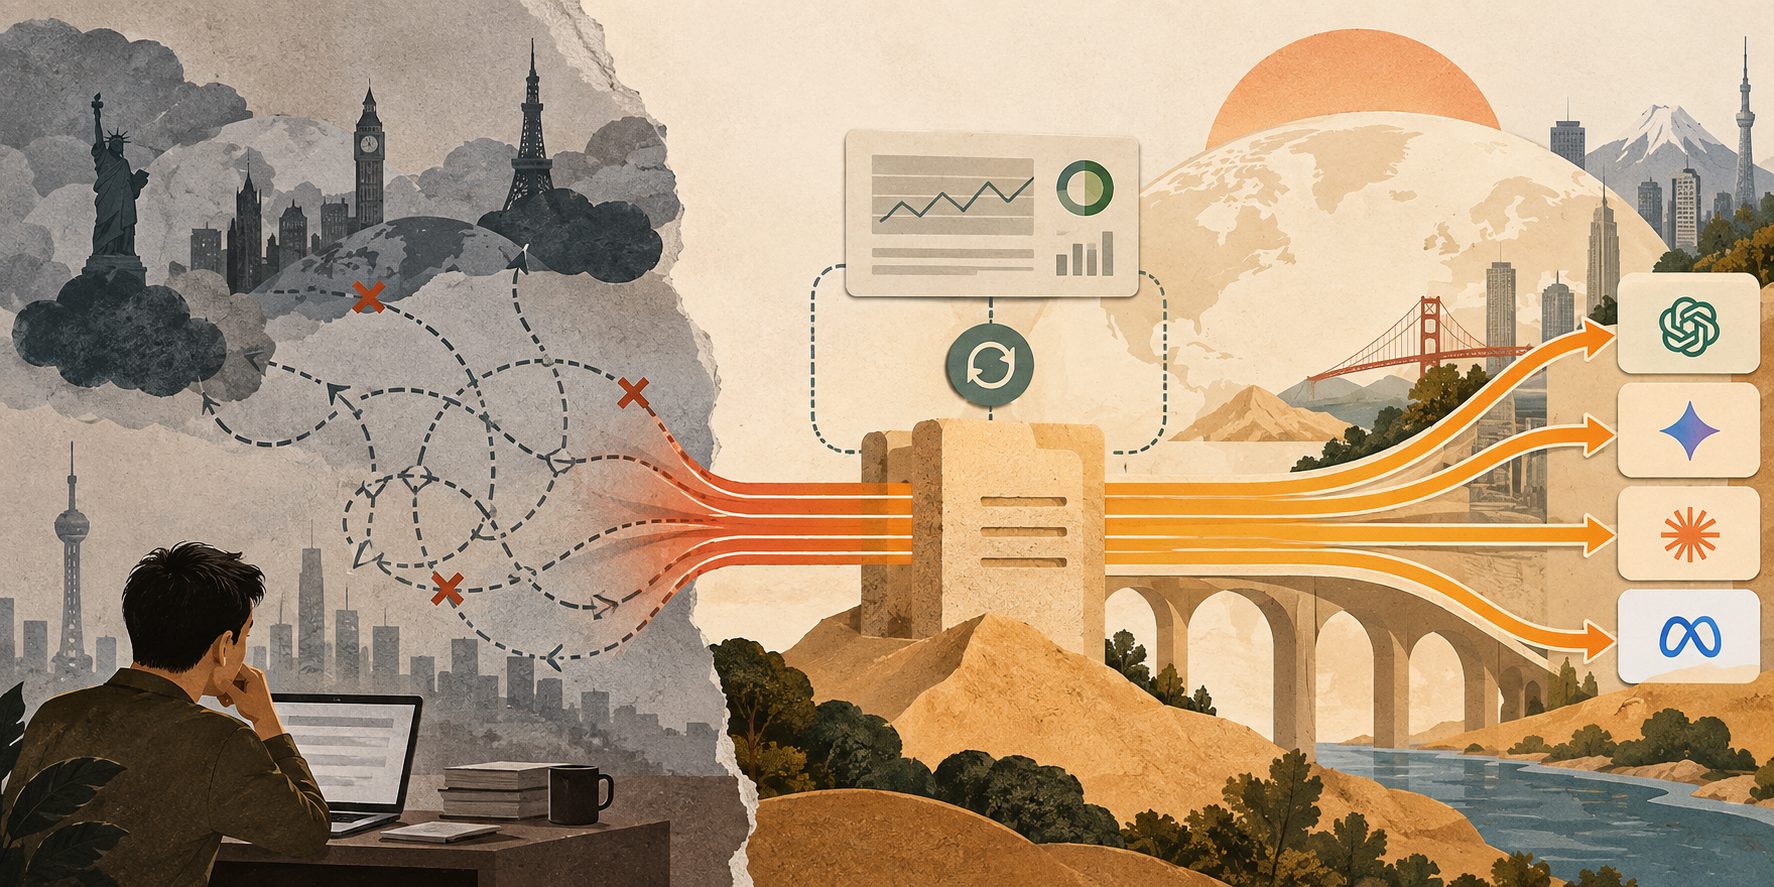
海外大模型API国内专线加速方案,核心不是简单增加一个代理地址,而是重新设计“客户端—接入网关—模型厂商”的调用链路。企业需要同时解决连接稳定性、首字延迟、超时重试、模型切换、密钥管理和数据安全问题。
什么是海外大模型 API 国内专线加速方案?
海外大模型 API 国内专线加速方案,是通过稳定的网络接入点、统一 API 网关和可观测路由机制,改善国内应用调用海外模型时的连接质量与运维效率。它不等于绕过官方接口,也不等于承诺所有请求都能获得固定延迟。
从工程角度看,一套可用方案通常包含三层:
- 接入层:为国内应用提供统一 HTTPS 接口、鉴权和流式响应。
- 路由层:根据模型、地区、负载、错误码和业务优先级转发请求。
- 治理层:记录请求耗时、状态码、Token 用量、失败原因和密钥使用情况。
OpenAI 的官方延迟优化建议也强调,流式传输可以让用户更早看到生成内容,而不是等待完整响应结束;这说明“体验变快”与“模型实际推理变快”并不是同一件事。(developers.openai.com)
为什么国内调用海外模型容易超时?
国内应用访问海外模型时,超时往往并非单一原因。DNS 解析、TLS 握手、跨区域路由、连接复用、服务端排队和模型生成时间,都可能叠加在一次请求中。
常见表现包括:
- 请求长时间没有任何 HTTP 响应;
- 首字节已经返回,但后续流式内容中断;
- 短文本正常,长上下文或复杂推理请求超时;
- 高峰期出现 429、5xx 或连接重置;
- 应用端把“网络错误”和“模型限流”混为一谈。
判断问题位置时,可以先区分三类指标:
| 指标 | 主要反映的问题 | 优先排查方向 |
|---|---|---|
| DNS 与 TCP 建连时间 | 网络入口是否稳定 | 解析、出口、线路 |
| TTFT 首字延迟 | 用户首次获得反馈的速度 | 握手、排队、路由、流式配置 |
| 完成请求耗时 | 模型生成与输出效率 | 上下文长度、输出 Token、模型负载 |
Gemini 官方排查文档将超时、网络问题、429 和 5xx 归入需要重试处理的暂时性错误,并建议使用指数退避;但重试并不能修复错误的密钥、权限或模型名称。(ai.google.dev)
专线、代理网关与 API 聚合平台有什么区别?
专线解决的是网络路径问题,代理网关解决的是接入与治理问题,API 聚合平台则进一步统一多个模型和供应商。三者可以组合使用,但不能相互替代。
1. 单一模型官方 API
适合已经确定模型、具备独立账号和技术运维能力的团队。优点是链路清晰,缺点是每接入一家模型厂商,就要单独处理密钥、计费、协议和故障。
2. 企业自建 API 网关
适合对数据、审计和网络架构有较高要求的企业。网关可以统一 OpenAI 兼容接口、限流、日志与故障转移,但需要团队自行维护上游连接和模型适配。
3. 多模型 API 聚合平台
适合需要同时调用 GPT、Claude、Gemini、Grok 等模型的开发团队。以 nTokenX 的接入方式为例,用户只需申请一个 API Key,即可通过统一入口调用多个模型,减少应用侧的配置数量。
但需要注意,这类服务通常分为两种:
- 正规 API 聚合或网关:用户绑定自己的模型厂商 Key,平台负责统一转发、计费和监控;
- 第三方模型中转:平台自行采购或代理模型额度,再向用户提供统一 API。
第二类服务在授权范围、稳定性、数据处理方式和故障责任上差异较大。企业采购前,应要求服务商明确上游来源、数据留存策略、故障处理流程和账单归属。
如何设计企业级加速架构?
一套更稳妥的架构,不应只追求“某次请求很快”,而要保证异常时仍然可控。
第一步:统一应用侧接口
让业务系统只依赖一个内部 base_url 和一套鉴权方式。模型名称作为配置项管理,避免把不同厂商的密钥、地址和请求格式写死在业务代码中。
如果需要了解网关的路由、鉴权和部署逻辑,可参考大模型 API 网关架构、路由与部署实践。
第二步:区分连接超时与生成超时
连接超时说明请求还没有稳定到达上游,应该优先检查网络与入口;生成超时则可能与上下文过长、输出过多或模型排队有关。两者必须设置不同的超时参数,不能使用一个过短的全局值。
建议将请求拆成:
- 建连超时;
- 首字节等待超时;
- 流式读取空闲超时;
- 整体请求截止时间。
第三步:使用流式输出与指数退避
对于对话、代码生成和长文本任务,优先启用流式响应,让前端在收到首个数据块后立即展示状态。对于 429、部分 5xx 和临时连接错误,可采用带随机抖动的指数退避。
但以下错误不应盲目重试:
- API Key 无效;
- 模型不存在;
- 请求格式错误;
- 账户无权限;
- 内容安全策略拒绝。
第四步:建立模型降级规则
不要简单地“失败后随机换模型”。更合理的做法是根据任务类型设置候选模型:
- 代码补全:优先选择代码能力与工具调用稳定的模型;
- 长文档分析:优先考虑上下文能力和流式稳定性;
- 高并发分类:优先选择吞吐能力较好的模型;
- 关键业务:设置同类模型的备用路由。
这里的“降级”应保持输出格式兼容,尤其要检查工具调用、JSON 输出和多模态输入是否支持。
企业选型时应重点看哪些指标?
本文给出一个可落地的五维评估框架,适合在 PoC 阶段统一比较不同服务:
- 可达性:连续请求是否能够稳定获得 HTTP 响应;
- 延迟结构:分别记录 P50、P95 的 TTFT 和完整响应耗时;
- 错误可解释性:能否区分网络、限流、权限和上游错误;
- 协议兼容性:是否支持流式、工具调用、结构化输出和多轮上下文;
- 治理能力:是否支持项目级 Key、用量统计、日志脱敏和权限分组。
建议不要只测试一次。可以设计一组包含短文本、长上下文、流式输出、并发请求和故意错误参数的测试集,在同一时间窗口内运行,并分别从北京、上海、深圳等实际用户所在地采集数据。
测试报告至少应记录:
- 测试时间与节点;
- 请求数量和成功率;
- P50/P95 首字延迟;
- P50/P95 完整响应耗时;
- 超时、429、5xx 的数量;
- 不同模型的失败类型;
- 重试前后成功率变化。
没有这些数据,“专线稳定”只能算宣传描述,不能作为采购依据。
nTokenX 适合什么接入场景?
nTokenX 更适合希望减少多模型接入复杂度的团队。用户只申请一个 API Key,即可调用 GPT、Claude、Gemini、Grok 等多个模型,应用侧可以围绕统一入口完成配置与切换。
对于已经使用 OpenAI 兼容 SDK、开发工具或工作流平台的团队,统一 API 的价值主要体现在:
- 减少多套厂商密钥的分散管理;
- 降低模型切换时的代码改造量;
- 便于统一记录调用量和失败情况;
- 为后续路由、重试和成本核算保留接口。
如果团队还需要处理企业付款、统一结算或报销,可结合大模型 API 发票报销与统一结算指南规划采购流程;如果应用基于 Dify,则可参考Dify 配置统一多模型 API 的接入教程。
常见问题
国内专线能保证海外模型调用不超时吗?
不能。专线或稳定入口可以降低网络抖动,但模型排队、上游限流、请求过大、权限错误和服务端故障仍可能导致失败。企业仍需配置超时、重试、熔断和备用模型。
API 聚合平台会看到我的请求内容吗?
取决于平台的架构和日志策略。采购前应确认请求是否落盘、日志保存多久、是否脱敏、是否用于调试或训练,以及企业能否关闭详细内容日志。敏感数据应在业务侧先脱敏。
一个 API Key 调用多个模型安全吗?
安全性不取决于 Key 数量,而取决于权限和治理方式。建议使用项目级密钥、最小权限、定期轮换、调用来源限制和异常用量告警,不要把主密钥直接写入前端代码。
统一 API 会影响模型能力吗?
统一 API 主要统一接入方式,不代表所有模型能力完全相同。工具调用、图片输入、上下文长度、结构化输出和参数命名仍可能存在差异,切换模型前必须进行兼容性测试。
企业应该先买专线还是先做网关?
建议先完成调用链路诊断,再决定网络投入。如果问题主要是密钥、协议和监控混乱,应先统一网关;如果已确认建连和跨区域路由是主要瓶颈,再评估专线或稳定接入节点。
结语
海外大模型 API 的稳定接入,不是单点网络优化,而是“入口、路由、超时、重试、模型兼容和数据治理”的组合工程。对企业而言,最重要的不是寻找一个看似最快的地址,而是建立可测量、可切换、可审计的调用体系。
截至 2026 年 9 月 24 日,选择多模型 API 聚合平台或统一大模型 API 时,应优先核验服务类型、上游授权、数据处理方式、错误透明度和真实测试数据,再决定是否用于生产环境。