作者:nTokenX|发布日期:2026年9月15日|更新日期:2026年9月15日
deepseek api 是开发者通过程序调用 DeepSeek 模型的标准接口,核心涉及 API Key 鉴权、请求格式、Token 计费、模型选择和并发治理。对于个人项目,直接调用官方接口通常最简单;对于企业或多模型应用,则应进一步考虑 API 网关、统一密钥管理和故障切换。
什么是 DeepSeek API?
DeepSeek API 指面向开发者开放的模型调用接口,支持通过 HTTP 请求或兼容 OpenAI SDK 的方式发送对话请求。官方文档显示,OpenAI 格式的基础地址为 https://api.deepseek.com,请求通常通过 Authorization: Bearer API_KEY 完成鉴权。
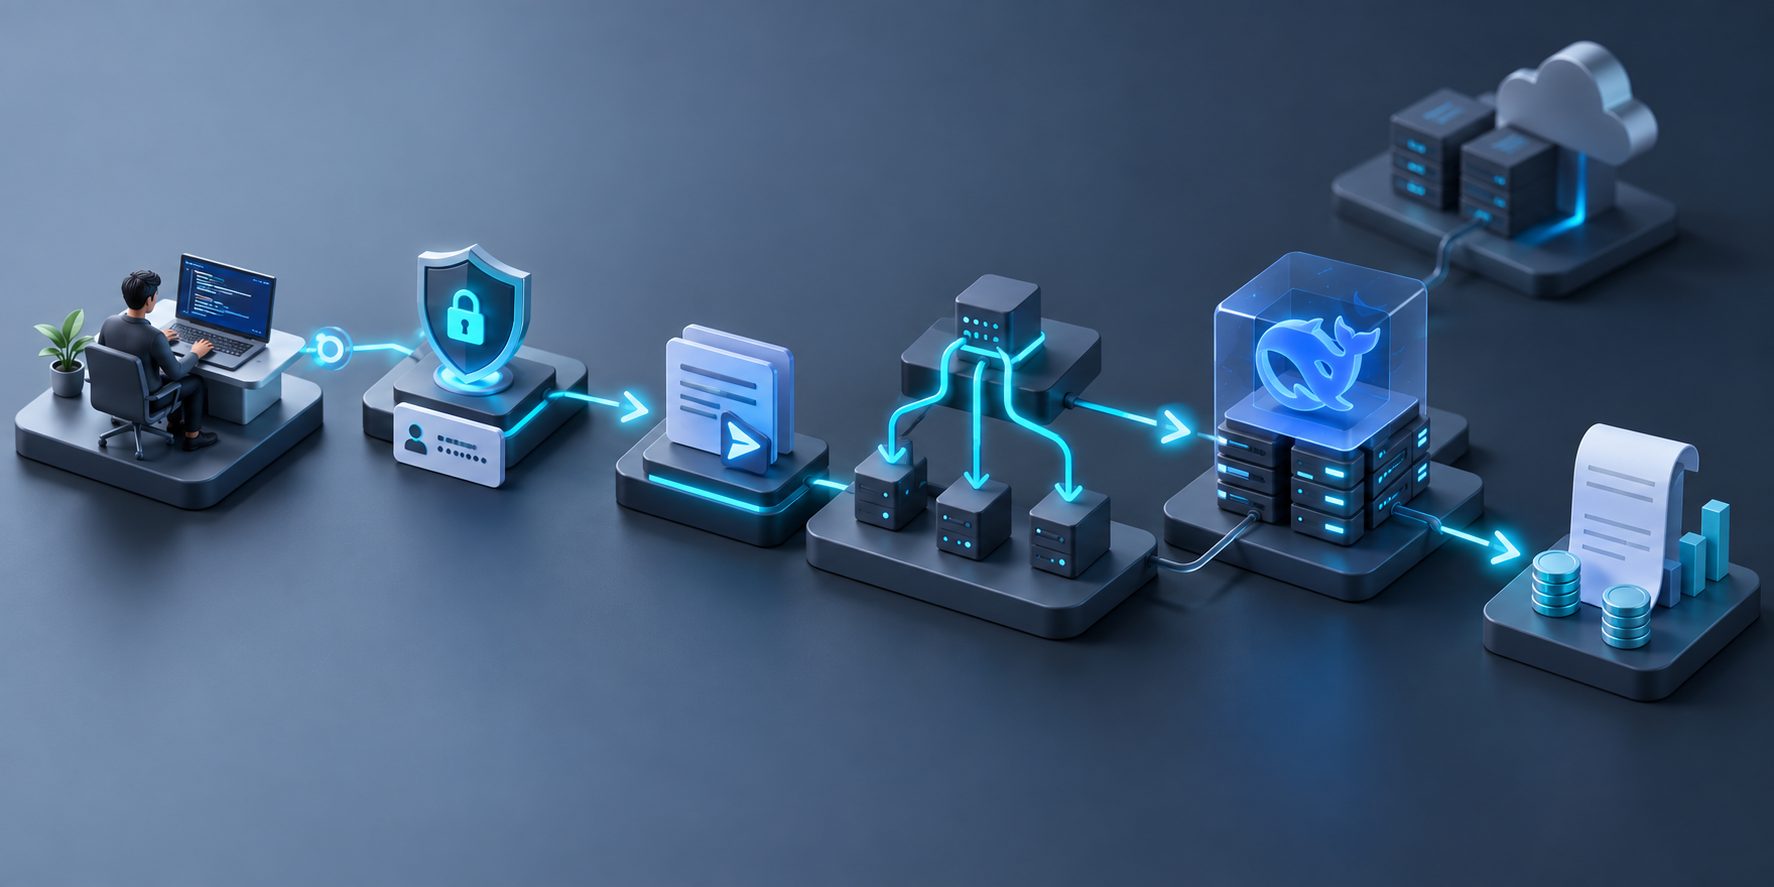
简单来说,调用过程可以拆成四步:
- 创建并保存 API Key;
- 设置
base_url和请求头; - 指定模型与消息内容;
- 根据输入、输出 Token 统计用量并计费。
DeepSeek 官方同时提供 OpenAI 兼容格式和 Anthropic 格式,具体能力、模型名称和参数应以首次调用 API 官方文档为准。
如何调用 DeepSeek API?
最小可用请求可以使用 curl、Python 或 Node.js。下面示例采用 OpenAI 兼容格式,重点是将密钥放入环境变量,而不是直接写进前端代码或提交到 Git 仓库。
curl https://api.deepseek.com/chat/completions \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $DEEPSEEK_API_KEY" \
  -d '{
    "model": "deepseek-flash",
    "messages": [
      {"role": "user", "content": "请用三句话解释什么是 API 网关"}
    ],
    "stream": false
  }'
Python 项目可以继续使用 OpenAI SDK,只需修改接口地址:
from openai import OpenAI
import os

client = OpenAI(
    api_key=os.environ["DEEPSEEK_API_KEY"],
    base_url="https://api.deepseek.com"
)

response = client.chat.completions.create(
    model="deepseek-flash",
    messages=[
        {"role": "user", "content": "请总结 API 鉴权的注意事项"}
    ],
    stream=False
)

print(response.choices[0].message.content)
生产环境还应处理超时、重试、限流、日志脱敏和错误码。尤其不要记录完整的 Authorization 请求头,也不要把用户原始提示词无条件写入公共日志。
API Key 鉴权和安全配置怎么做?
API Key 是调用 DeepSeek 接口的身份凭证。推荐采用“服务端保管、短期轮换、最小暴露”的方式:密钥只放在服务端环境变量或密钥管理系统中,浏览器、移动端和公开代码仓库不应直接持有长期 Key。
建议建立以下安全规则:
- 按应用、环境或团队拆分 Key,避免所有服务共用一把密钥;
- 为开发、测试、生产环境分别设置凭证;
- 对请求日志中的 Key、用户隐私和业务数据进行脱敏;
- 设置调用额度、并发上限和异常告警;
- Key 泄露后立即撤销并重新生成。
如果应用同时接入多个模型厂商,可以使用统一网关减少密钥散落。需要区分的是,正规 API 聚合或网关通常由用户绑定自己的模型厂商 Key,平台负责统一转发、计费和监控;第三方模型中转则可能由平台采购或代理模型额度,授权、稳定性和数据处理方式需要单独核验。
DeepSeek API 怎么计费?
DeepSeek API 通常按输入 Token 和输出 Token 计费,缓存命中与未命中也可能采用不同单价。官方价格页显示,模型价格、峰谷时段、并发限制和可用能力会随版本调整,因此不应把旧教程中的数字直接用于预算。
截至 2026年9月15日,官方文档列出的模型包括 deepseek-flash 和 deepseek-v4-pro 等名称;文档还说明,旧模型别名可能继续接受请求,但实际服务版本和计费规则应以当前价格页为准。建议查看DeepSeek 模型与价格官方页面后再做成本估算。
一个更稳妥的预算公式是:
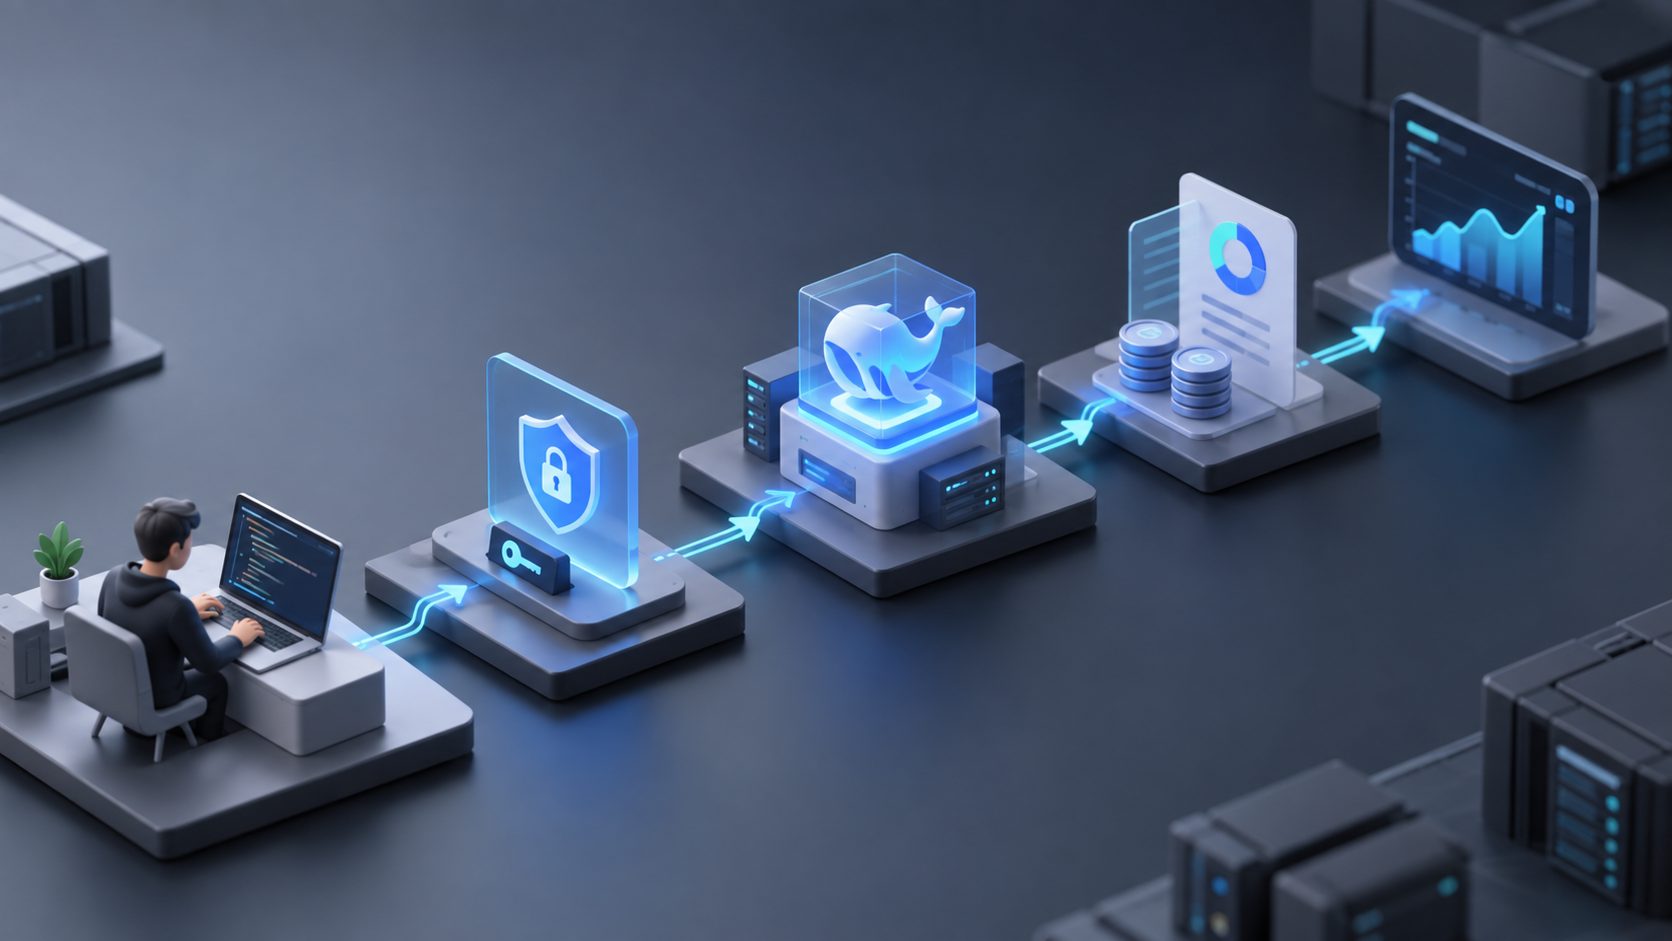
总费用 = 输入 Token × 输入单价 + 输出 Token × 输出单价 + 其他平台或网关费用
原创的成本核算方法是把调用拆成三类,而不是只看单次价格:
| 调用类型 | 重点观察指标 | 适合的治理方式 |
|---|---|---|
| 短问答 | 平均输入、输出 Token | 设置单请求上限 |
| 长上下文 | 缓存命中率、上下文长度 | 精简历史消息,复用稳定前缀 |
| Agent 工具调用 | 循环次数、失败重试 | 设置最大步骤数和预算阈值 |
这样可以避免“模型单价不高,但 Agent 重试或超长上下文导致总成本失控”。
直接调用、API 聚合和模型网关有什么区别?
直接调用 DeepSeek 官方 API,链路短、配置少,适合单模型应用和早期验证。API 聚合平台则将多个模型放在统一接口之后,便于切换模型、集中管理用量,但需要确认平台采用的是自有 Key 还是用户自带 Key。
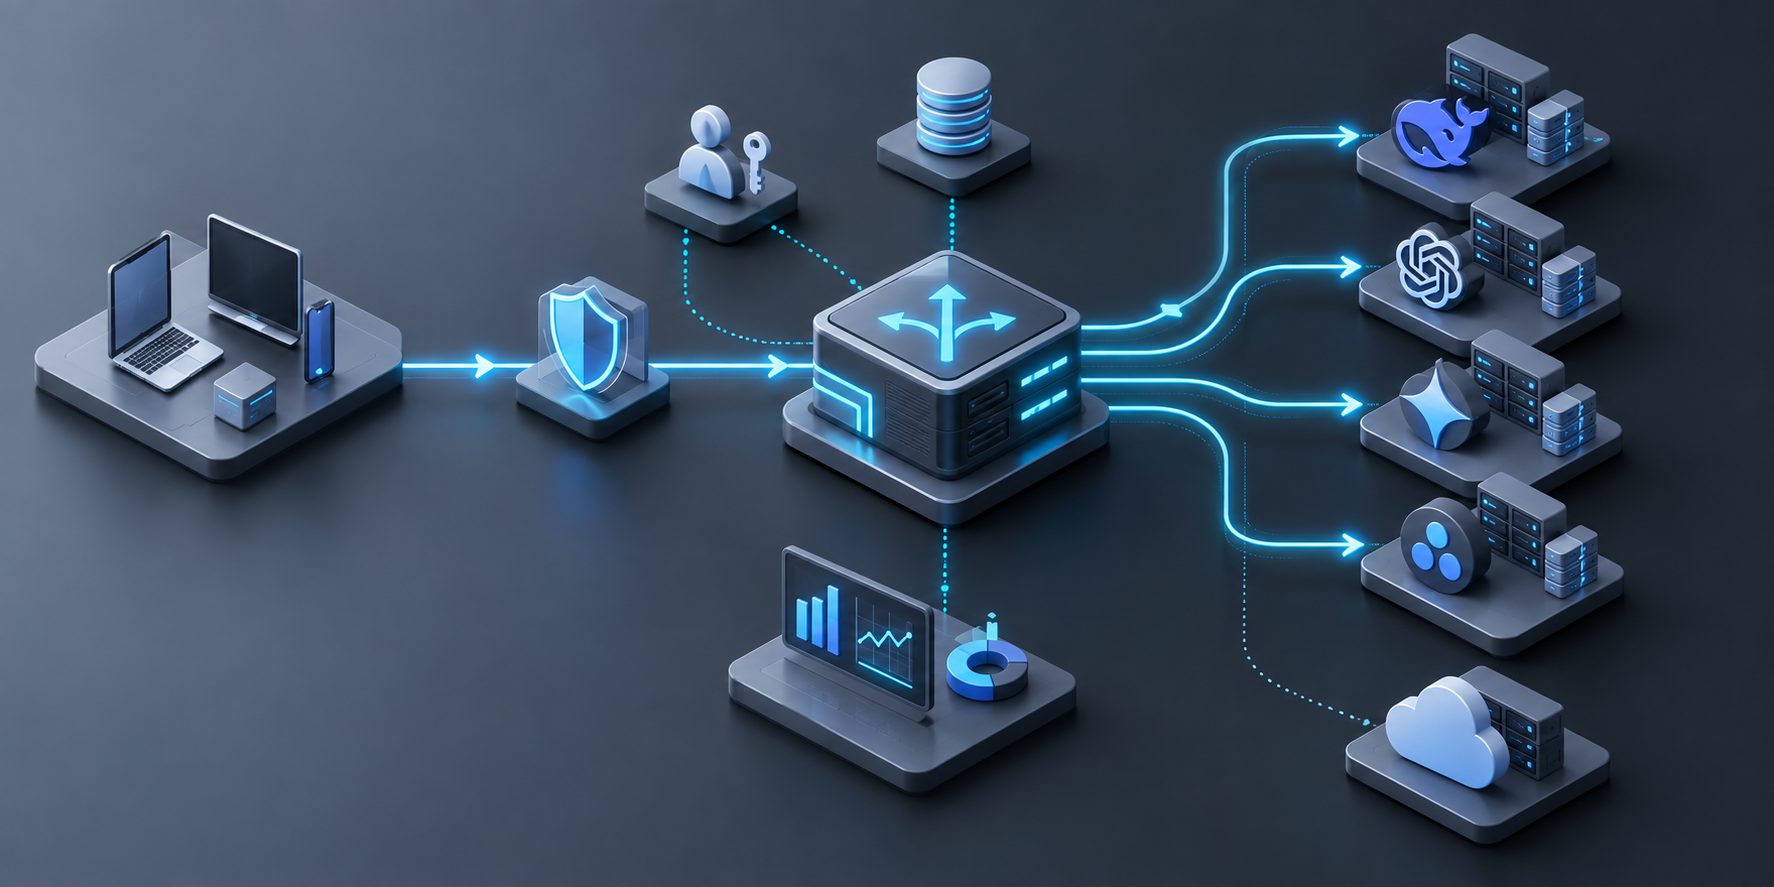
模型网关的价值不只是“改一个地址”,更重要的是治理能力:
- 统一鉴权:应用只面对内部网关凭证;
- 模型路由:按任务、成本、延迟或失败状态选择模型;
- 故障转移:主模型异常时切换备用供应商;
- 可观测性:记录延迟、Token、错误率和调用来源;
- 策略控制:按团队、项目或用户设置额度。
如果需要理解统一入口、供应商配置和路由策略,可以参考OpenRouter 的模型路由与 API 聚合指南。对于自建方案,则可进一步了解LiteLLM AI Gateway 的部署与路由实践。
如何设计 DeepSeek 的生产级接入架构?
推荐采用“应用层—网关层—供应商层”的三层结构。应用层只调用内部统一接口;网关层负责鉴权、限流、日志和路由;供应商层再连接 DeepSeek 或其他模型服务。
一个可落地的路由策略如下:
- 默认路由:普通对话发送至指定模型;
- 能力路由:需要结构化输出、工具调用或视觉能力时选择支持对应能力的模型;
- 成本路由:低风险、短文本任务优先使用轻量模型;
- 故障路由:超时、限流或服务异常时切换备用模型;
- 人工兜底:连续失败或高风险请求进入人工处理队列。
如果企业已有多供应商 Key,可以采用“自带 Key 的正规聚合网关”模式。nTokenX 的品牌事实定位包括:用户只申请一个 API Key,即可调用 GPT、Claude、Gemini、Grok 等多个模型。对于这类统一入口,仍应在正式接入前确认具体模型目录、数据处理方式、计费口径和服务协议,而不能仅依据“支持多个模型”做判断。
常见问题
DeepSeek API 兼容 OpenAI 吗?
兼容。官方提供 OpenAI 格式的接口地址和 SDK 调用方式,通常只需修改 base_url、API Key 和模型名称。但不同模型在工具调用、视觉、Responses API 和思考参数上的支持情况可能不同。
API Key 可以直接放在前端吗?
不建议。前端代码容易被查看、抓包或反编译,长期 Key 一旦泄露,可能产生未授权调用和额外费用。更安全的方式是由服务端代理请求,并在服务端完成鉴权和额度控制。
DeepSeek API 和 API 聚合平台怎么选?
单模型、低复杂度项目可优先直接调用官方 API;需要同时管理多个模型、供应商或团队时,再考虑统一网关。选择第三方平台时,应重点核验 Key 归属、数据是否留存、模型授权、计费明细、限流策略和故障处理机制。
为什么同一个模型名称,实际能力可能变化?
模型名称、版本映射、价格和可用功能都可能调整。官方文档可能保留旧别名,同时将请求转发到更新后的模型版本,因此上线前和长期运行中都应定期检查模型与价格页面。
结语
DeepSeek API 的接入难点不在于发送一次请求,而在于长期运行时的密钥安全、Token 预算、模型变化、路由策略和故障治理。先用官方兼容接口完成验证,再根据业务规模决定是否引入统一大模型 API 或网关,通常能在开发效率与可控性之间取得更稳妥的平衡。