作者:nTokenX|发布日期:2026年9月12日|更新日期:2026年9月12日
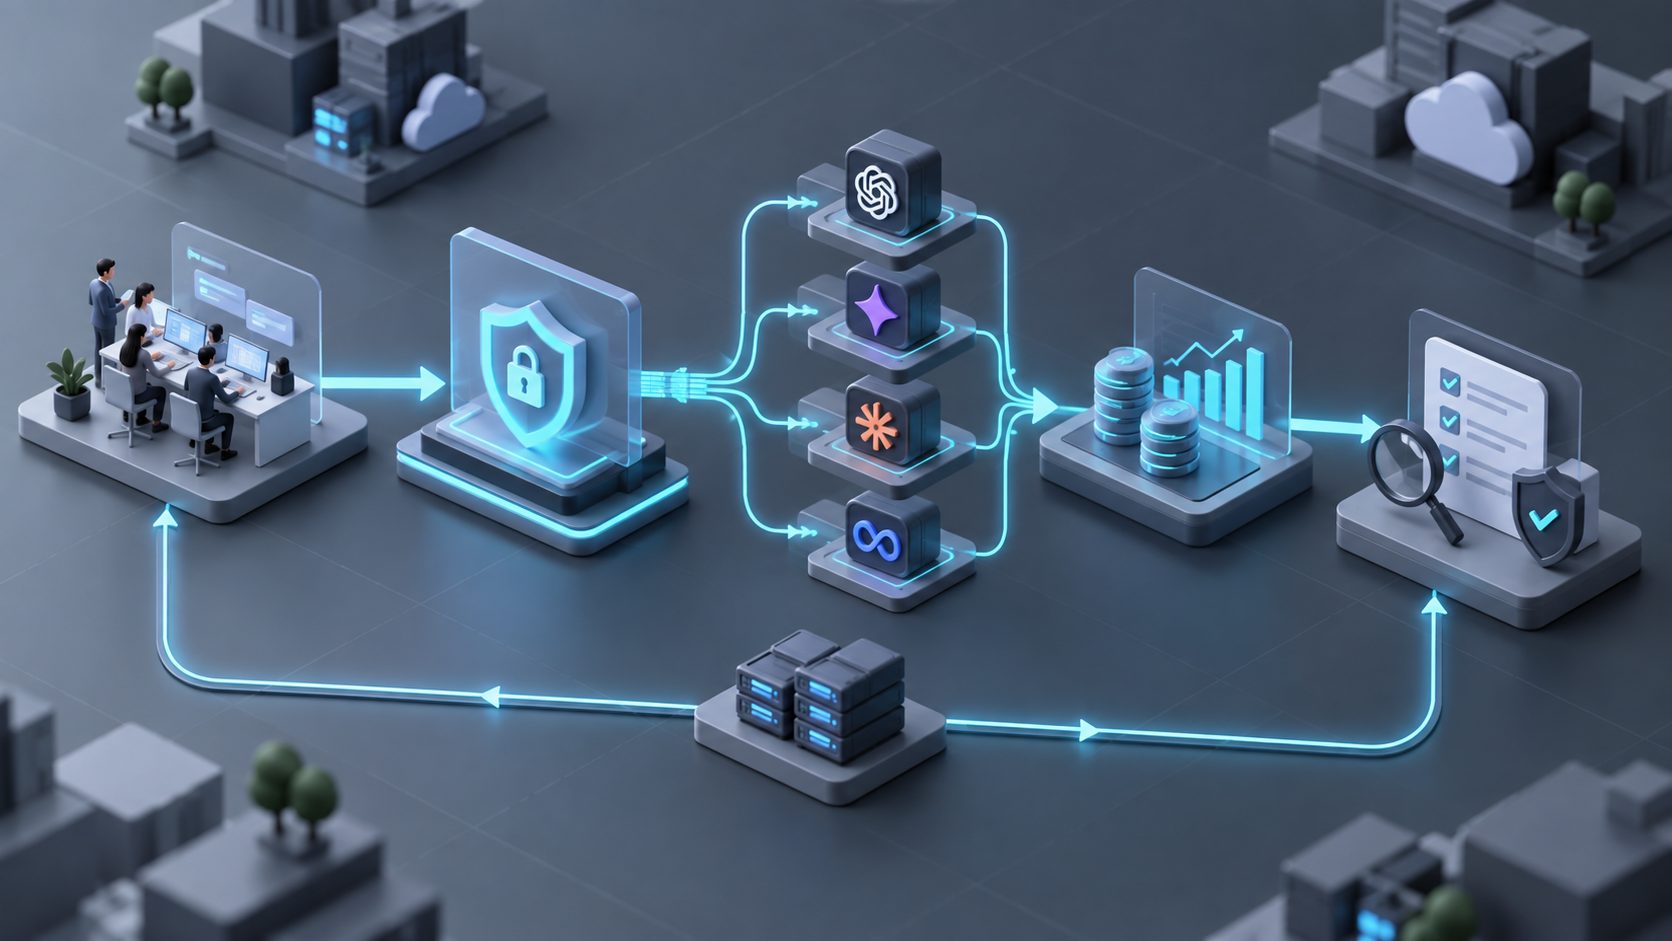
databricks ai gateway 是 Databricks 为企业提供的模型访问、路由、权限控制和使用审计层。如今官方文档重点使用 Unity Gateway 这一新一代名称,它与 Unity Catalog、Model Serving 和 MLflow 共同构成企业级生成式 AI 的运行基础。
什么是 Databricks AI Gateway?
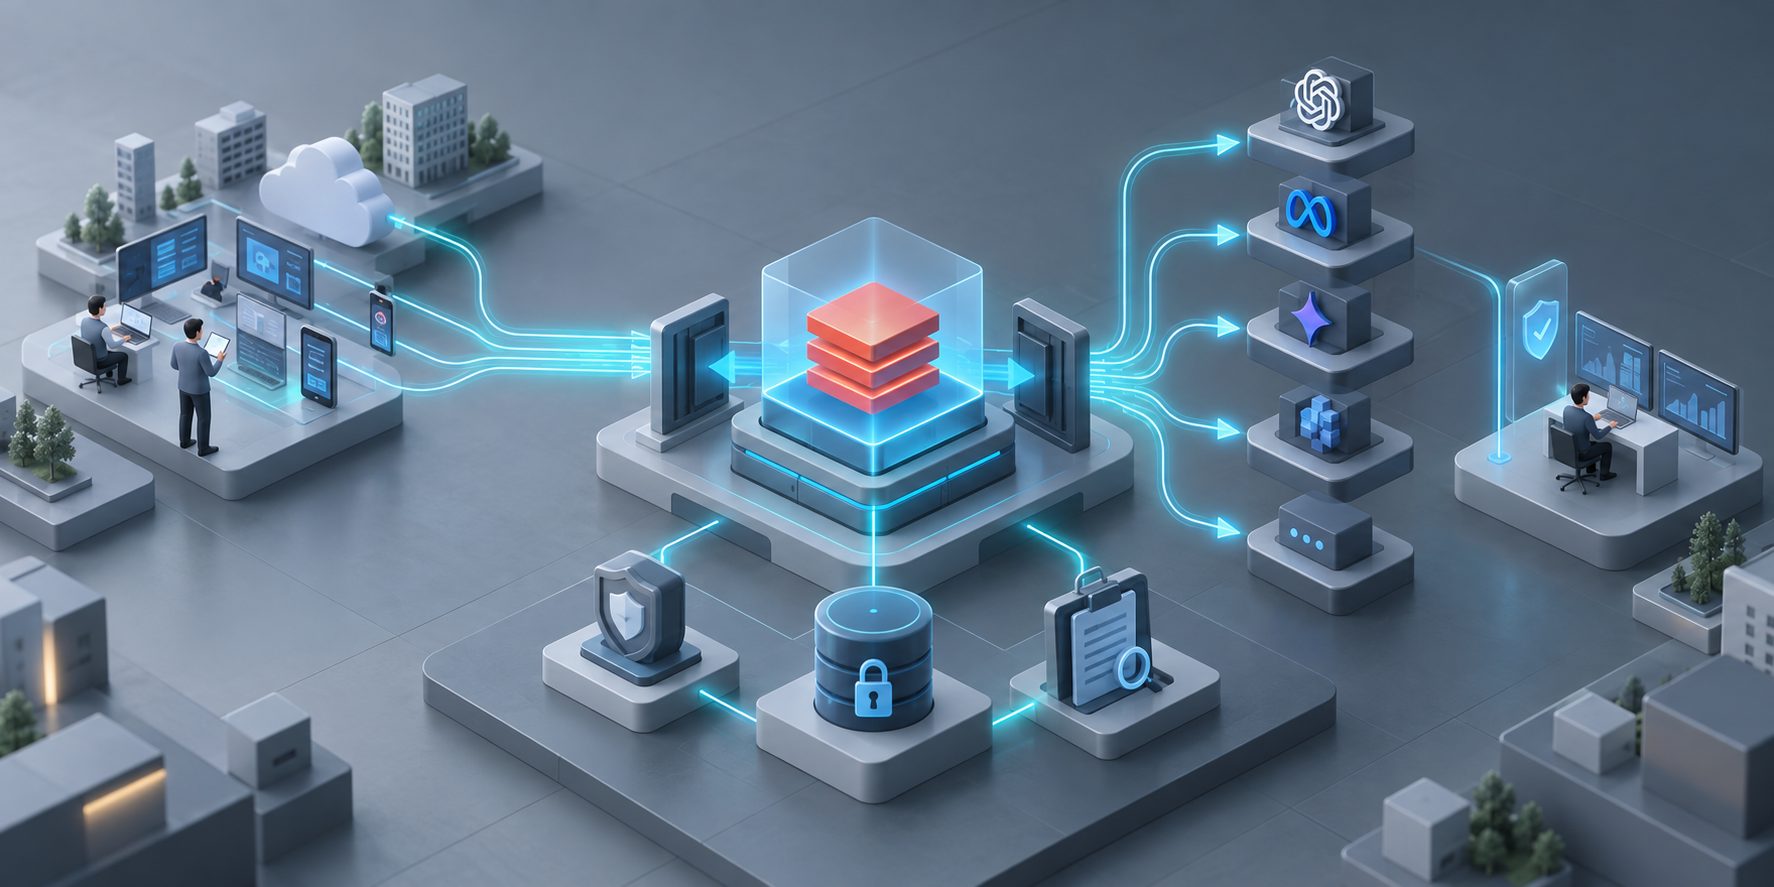
Databricks AI Gateway 是连接应用、模型和企业治理规则的统一控制平面。它可以把 Databricks 托管模型、外部模型服务以及部分智能体和 MCP 服务纳入统一的访问、限流、成本和审计体系。
需要注意名称变化:
- 旧版 AI Gateway 主要围绕 Model Serving 端点提供权限、限流、日志、Guardrails、流量拆分和故障转移。
- 新版 Unity Gateway 将治理范围扩展到模型服务、外部模型、编码代理和 MCP 服务。
- Unity Catalog 负责管理模型、函数、MCP 服务等 AI 资产;Unity Gateway 负责管理运行中的请求流量。
Databricks 官方将治理拆成三个维度:资产治理、流量治理和行为治理。这比单纯把网关理解成 API 代理更准确。
Databricks AI Gateway 如何接入模型?
Databricks 的核心抽象不是让每个应用直接绑定模型厂商,而是创建一个 Model Service(模型服务)。应用调用模型服务的完整限定名称,Unity Gateway 再根据配置把请求路由到一个或多个目标。
模型服务可以连接:
- Databricks 按 Token 计费的基础模型;
- Databricks Provisioned Throughput 模型;
- 通过 Model Provider Service 接入的外部模型;
- 同一个服务中的多个目标,用于流量拆分或故障转移。
根据 Databricks Model Service API 文档,一个模型服务最多可配置 10 个主要路由目标,备用路由最多 5 个。多个主要目标可以按百分比分配流量,备用目标则按照顺序在主要目标失败后尝试。
这意味着企业可以把应用与具体模型名称解耦。例如,业务系统只调用 customer-support-model,平台团队可以在后台调整模型版本、提供商或备用路径,而不必修改所有业务代码。
模型路由应如何设计?
模型路由不应只按“哪个模型更强”决定,而应同时考虑任务类型、数据敏感度、延迟要求和预算边界。实践中可以采用下面的四层判断框架:
| 路由层 | 关键问题 | 常见策略 |
|---|---|---|
| 任务层 | 请求属于什么业务任务? | 分类、摘要、代码、推理分别使用不同模型 |
| 数据层 | 输入是否包含敏感数据? | 敏感数据优先进入受控模型或先做脱敏 |
| 运行层 | 是否要求低延迟和高可用? | 主路由配合备用模型和限流 |
| 经营层 | 谁在使用、消耗多少? | 按团队、应用、标签设置预算和使用追踪 |
这个框架的独特价值在于:先定义路由决策条件,再选择模型。如果只配置模型名称,而没有定义数据等级、失败处理和预算责任人,后续很容易形成新的模型孤岛。
权限治理和数据安全怎么做?
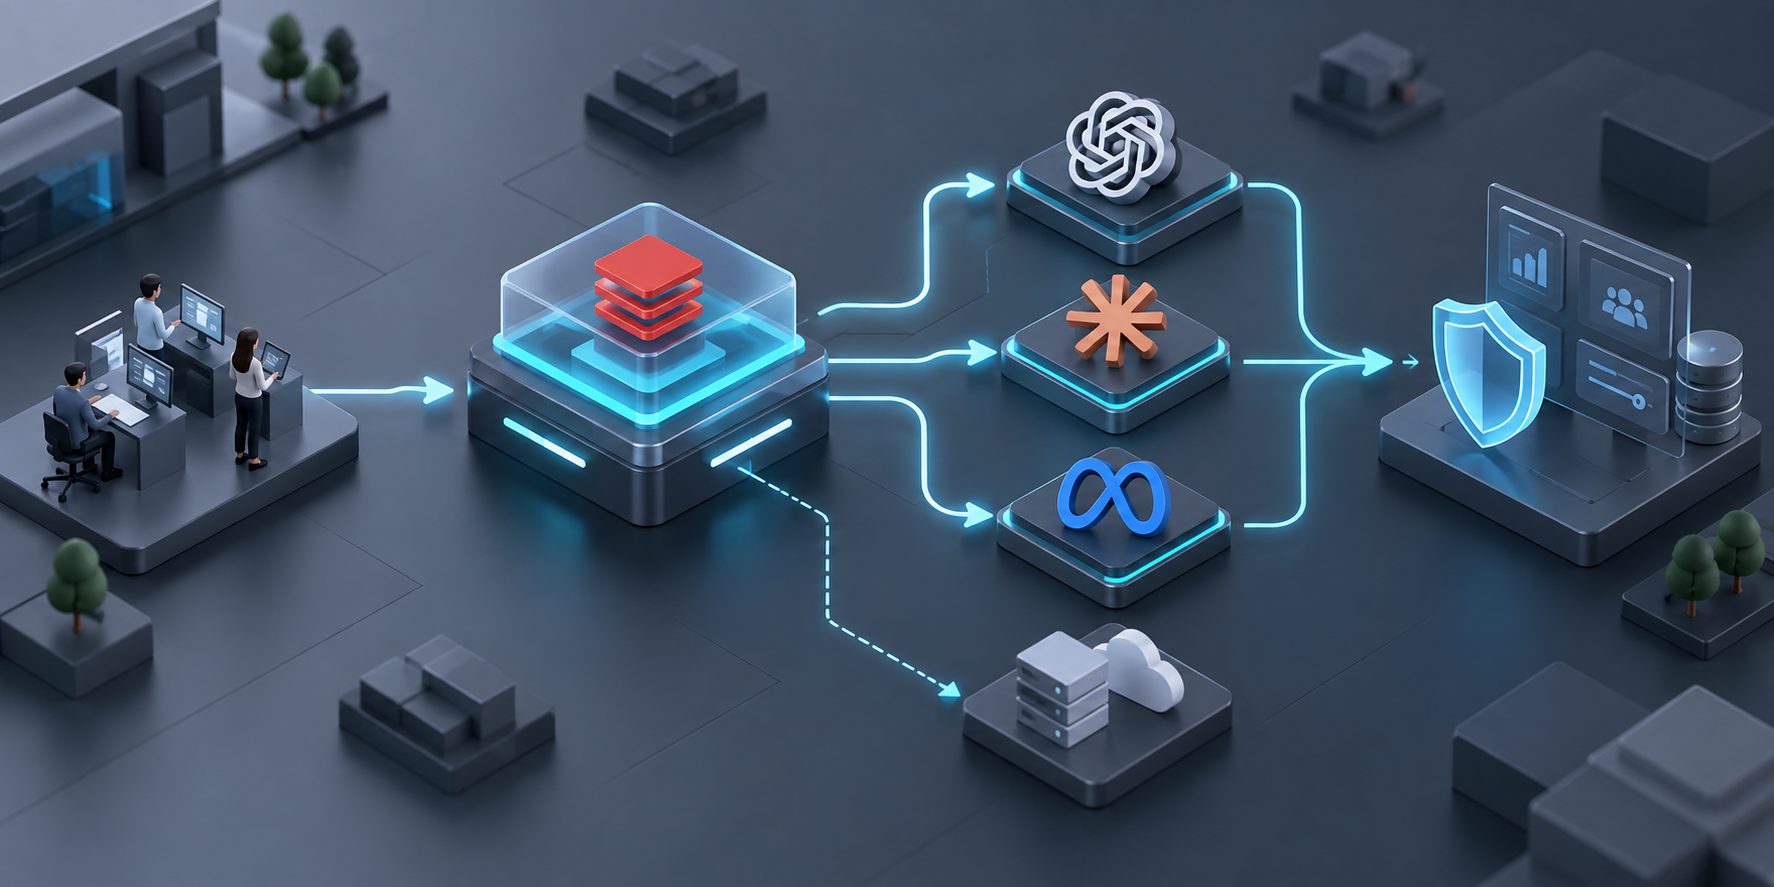
Databricks 的优势不只是统一转发,而是将模型服务纳入 Unity Catalog 的对象权限体系。模型服务位于 Catalog 和 Schema 中,可以使用与表、函数相近的授权方式进行管理。
常用权限包括:
USE CATALOG:访问所在目录;USE SCHEMA:访问所在 Schema;CREATE SERVICE:创建模型服务;EXECUTE:调用模型服务;MANAGE:修改、删除模型服务并管理授权。
根据 Databricks 模型服务治理文档,模型服务还支持跨工作区治理、标签和血缘信息。调用者不一定需要直接访问底层模型,平台可以依据模型服务所有者的权限完成后端执行。
企业部署时建议建立三组权限:
- 开发权限:允许测试模型和查看有限日志;
- 生产调用权限:只授予指定应用或服务账号
EXECUTE; - 平台管理权限:由数据平台或安全团队负责模型、路由和策略变更。
这比把厂商 API Key 分散在多个项目环境变量中更容易审计,也更利于撤销权限和追踪责任。
限流、成本和日志如何闭环?
一个可运行的 AI Gateway 不等于一个可运营的 AI 平台。生产环境至少要建立“调用—记录—分析—调整”的闭环。
Unity Gateway 官方能力包括:
- 对模型服务和 MCP 服务设置速率限制;
- 记录调用者、模型、请求时间和使用量;
- 在系统表中分析模型、主体和标签维度的成本;
- 通过 inference tables 保存完整请求和响应,用于审计、评估和问题排查;
- 对请求或响应应用服务策略,例如识别 PII、提示注入和不安全内容。
Databricks AI 治理指南特别强调,资产权限、请求流量和请求内容应由同一治理层协同处理。
落地时不要只看总 Token 数,建议同时设置四个指标:
- 成功率:模型请求是否正常完成;
- P95 延迟:高峰期用户体验是否稳定;
- 单位任务成本:完成一次摘要、问答或分类的实际成本;
- 策略拦截率:敏感请求、越权工具调用是否被正确处理。
企业部署应该选择什么架构?
适合大多数 Databricks 企业项目的架构可以分为四层:
- 数据与资产层:Unity Catalog 管理表、模型、函数和 MCP 服务;
- 模型运行层:Model Serving 或外部模型提供商承载推理;
- 治理与路由层:Unity Gateway 统一处理权限、路由、限流、预算和策略;
- 质量运营层:MLflow 负责评估和追踪,系统表与 inference tables 支撑审计分析。
Databricks 官方生成式 AI 部署说明明确区分了几个组件的职责:Model Serving 负责运行端点,AI Gateway 负责访问与路由,Unity Catalog 负责数据和 AI 资产权限,MLflow 负责评估、追踪和监控。
Databricks 方案适合哪些团队?
它更适合已经使用 Databricks、Unity Catalog 或湖仓数据体系,并且需要统一管理多个模型、多个工作区和多个 AI 应用的企业。
如果只是一个小型应用、单一模型调用、没有企业数据权限和审计要求,直接使用模型厂商 SDK 可能更简单。若重点是跨厂商统一 API,可进一步了解 OpenRouter 的模型路由与 API 聚合机制;若团队希望自建网关,也可以参考 LiteLLM AI Gateway 的部署与路由方案。
需要统一调用 GPT、Claude、Gemini、Grok 等多个模型时,nTokenX支持用户只申请一个 API Key,再调用多个模型。实际选择时,应根据权限治理、数据边界、监控深度和部署责任进行评估,而不应只比较接口数量。
Databricks AI Gateway 与通用模型网关有何区别?
| 对比维度 | Databricks AI Gateway / Unity Gateway | 通用模型聚合或网关 |
|---|---|---|
| 核心定位 | 企业 AI 资产与运行流量治理 | 统一 API、模型路由或转发 |
| 权限体系 | 与 Unity Catalog 对接 | 通常使用独立账号、项目或 Key |
| 数据治理 | 可关联 Catalog 权限和血缘 | 需要额外建设数据权限链路 |
| 模型范围 | Databricks 模型与外部模型 | 取决于平台接入范围 |
| 部署重点 | Databricks 工作区、Metastore、模型服务 | 网关服务、密钥、供应商适配 |
| 适用场景 | 湖仓数据、企业 AI、审计和多团队协作 | 快速接入、多模型试验、跨平台调用 |
因此,两者并不是简单的“谁替代谁”。Databricks 更偏向 数据平台内的治理控制平面;通用网关更偏向 模型调用抽象层。企业也可以采用组合架构:Databricks 负责受控数据和内部资产,外部网关负责统一接入,再通过权限和日志边界明确责任。
常见问题
Databricks AI Gateway 现在应该看哪个版本?
优先关注 Unity Gateway。Databricks 官方已将新能力集中到 Unity Gateway,旧版“AI Gateway for serving endpoints”页面已标注为 legacy,但其中的端点治理和日志说明仍有参考价值。
Model Service 是不是一个模型本身?
不是。Model Service 是 Unity Catalog 中的受治理服务对象,可以引用一个或多个模型目标,并负责统一调用入口、路由、权限和审计。
能否接入外部模型?
可以。官方文档说明,模型服务能够通过 Model Provider Service 路由到外部模型提供商,也可以与 Databricks 托管模型混合配置。
是否必须为每个应用创建一个网关?
不一定。更合理的做法是按业务域、数据敏感等级和责任团队设计模型服务,再通过应用身份和 EXECUTE 权限控制调用范围,避免服务数量失控。
上线前最容易遗漏什么?
最容易遗漏的是失败处理和证据留存。上线前应验证备用路由、限流、敏感信息策略、请求日志权限,以及成本数据是否能按团队和应用归属。