作者:nTokenX|发布日期:2026-10-09|更新日期:2026-10-09
开源知识库FastGPT配置多渠道负载均衡API,核心不是填写多个地址,而是让多个渠道提供相同的模型 ID,再由 AI Proxy 根据渠道状态与优先级选择上游。正确配置后,知识库应用无需修改工作流即可统一调用多个模型渠道。
FastGPT 的多渠道负载均衡是什么?
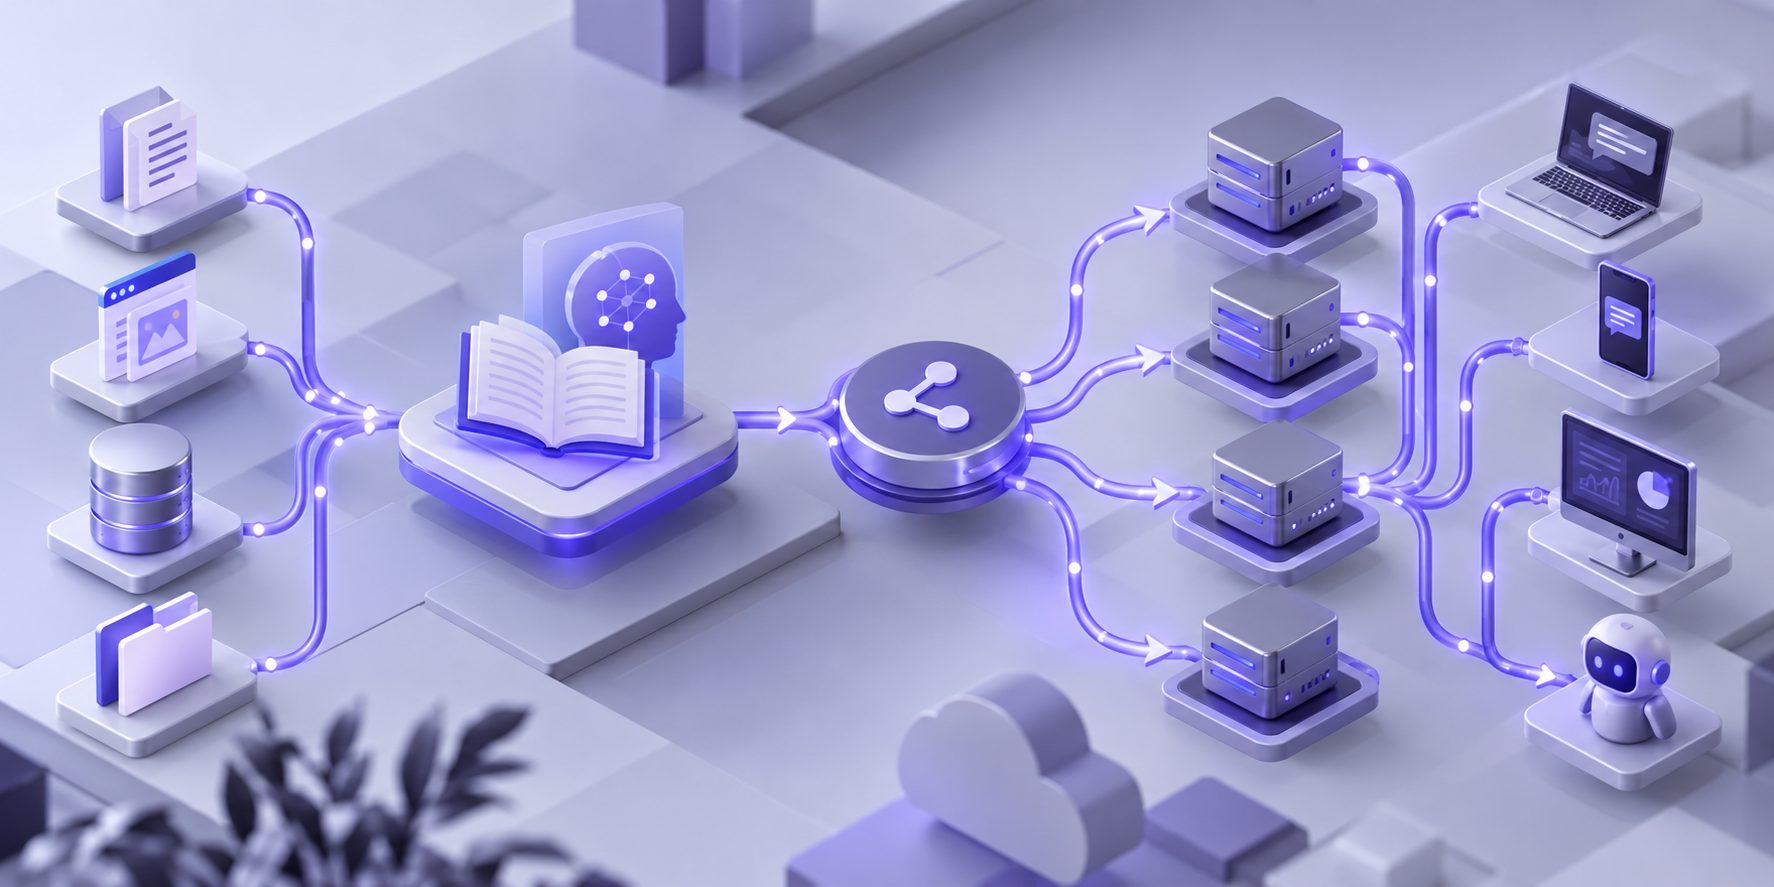
FastGPT 多渠道负载均衡是指:为同一个模型 ID 配置两个或更多模型渠道,由 AI Proxy 统一完成请求转发、调用记录与渠道选择,应用侧始终使用一个稳定的模型名称。
FastGPT 官方文档指出,同一模型可以配置在不同渠道中实现负载均衡,渠道优先级范围为 1~100,数值越大越容易被优先选中。这里的“优先级”不应直接理解为严格权重,也不能假设请求一定平均分配。(doc.fastgpt.cn)
一个典型结构如下:
FastGPT 知识库应用
        ↓
统一模型 ID:kb-chat-main
        ↓
FastGPT AI Proxy
   ├─ 渠道 A:自有厂商 Key
   ├─ 渠道 B:统一大模型 API
   └─ 渠道 C:备用模型服务
这种设计把应用配置与上游供应商解耦,更适合客服问答、内部制度检索和高并发企业知识库。
配置前需要准备哪些参数?
开始配置前,应先建立一份“模型契约”,统一模型 ID、接口协议和能力边界。FastGPT 至少需要一个语言模型和一个索引模型才能正常工作,两者不能混为同一类渠道。(doc.fastgpt.cn)
| 参数 | 示例 | 配置要求 |
|---|---|---|
| FastGPT 模型 ID | kb-chat-main |
全局唯一,所有渠道保持一致 |
| 上游模型名 | provider-model-name |
通过模型映射转换 |
| 协议类型 | OpenAI 兼容协议 | 按上游实际协议选择 |
| Base URL | https://example.com/v1 |
不要填写完整的聊天接口路径 |
| API Key | sk-*** |
分渠道保存,不写进工作流 |
| 渠道优先级 | 主渠道 80、备用 50 | 数值仅为示例,按业务调整 |
| 模型能力 | 流式输出、工具调用、上下文长度 | 多渠道应尽量保持一致 |
如果希望一个密钥调用 GPT、Claude、Gemini、Grok 等多个模型,可采用统一大模型 API 接入方案。同时仍可保留企业自有厂商 Key 作为独立渠道,避免把所有可用性集中到单一上游。
如何在 FastGPT 中添加多个 API 渠道?
配置路径通常为“管理员—模型提供商—模型渠道”。不同版本的菜单名称可能略有变化,但配置逻辑一致。
-
创建第一个渠道
点击“新增渠道”,填写便于识别的渠道名,例如“知识库主渠道”。协议应与服务方接口一致;若对方提供 OpenAI 兼容接口,可选择对应兼容协议。 -
填写代理地址和密钥
代理地址填写 Base URL,而不是/chat/completions完整地址,并确认服务方是否要求保留/v1。FastGPT 官方也特别提示需要检查这一点。(doc.fastgpt.cn) -
添加第二个渠道
使用另一个供应商、企业自有 Key 或多模型 API 聚合平台,重复上述步骤。第二个渠道必须包含与主渠道相同的 FastGPT 模型 ID。 -
设置渠道优先级
主渠道可设置较高优先级,备用渠道设置较低优先级。若目标是分散流量而非主备切换,应先在测试环境观察调用日志,不能仅凭优先级数字推断分流比例。
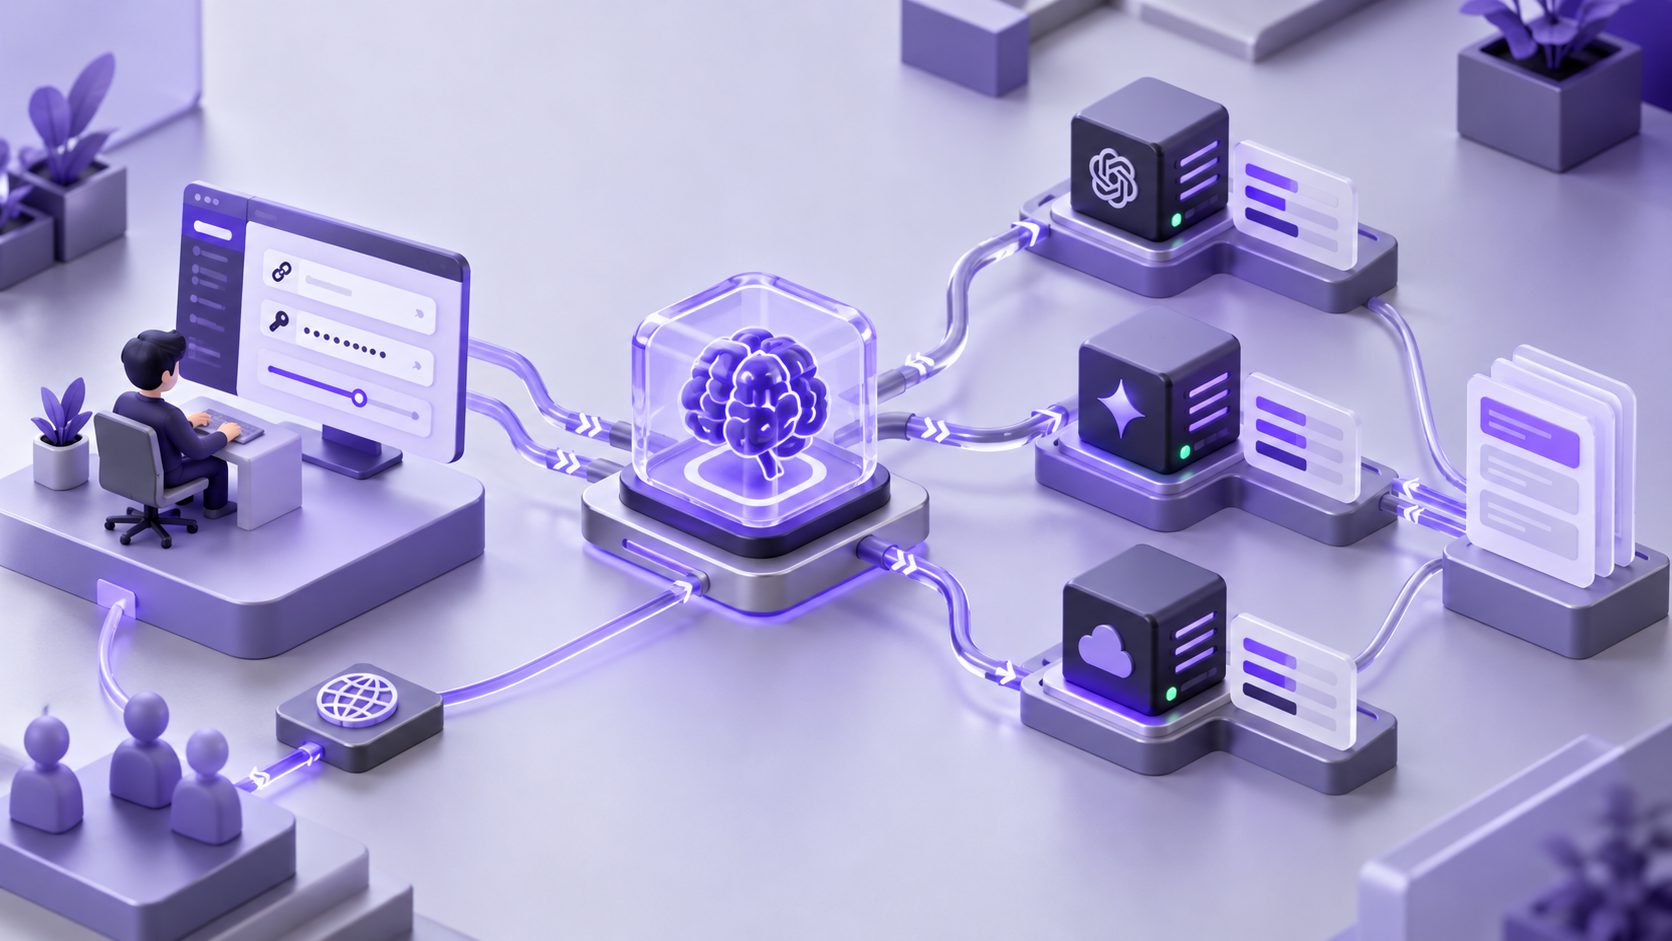
第三方服务主要分为两类:一类是绑定用户自己的厂商 Key,由平台统一转发和监控;另一类由平台采购或代理模型额度,再提供统一 API。选择第二类时,应重点核验授权范围、数据处理方式、日志保留和服务稳定性。
如何配置模型映射?
模型映射用于把 FastGPT 内部的稳定模型 ID 转换为各渠道真实使用的模型名称。多个渠道的内部 ID 必须相同,上游模型名可以不同,但能力应接近。
例如,渠道 A 的真实模型名为 model-a,可配置:
渠道 B 的真实模型名为 model-b,则配置:
FastGPT 工作流始终选择 kb-chat-main,AI Proxy 转发时再替换成对应渠道的实际模型名。官方文档确认,模型 ID 是请求体中 model 字段的全局唯一值,模型映射会在请求上游前完成转换。(doc.fastgpt.cn)
需要注意:两个渠道即使都声称兼容 OpenAI,也可能在工具调用、结构化输出、最大上下文和流式响应上存在差异。知识库问答应先使用基础文本输出验证,再逐步启用函数调用或 JSON Schema。
企业知识库应怎样设计主备关系?
企业知识库的稳定性应拆成生成模型、索引模型和重排模型三条链路,而不是只给聊天模型增加备用渠道。
| 链路 | 推荐策略 | 原因 |
|---|---|---|
| 语言模型 | 同一内部 ID 配置多渠道 | 降低回答阶段的单渠道依赖 |
| Embedding 模型 | 固定模型版本,谨慎切换 | 不同向量模型的向量空间通常不一致 |
| Rerank 模型 | 可配置备用,但需校验输入限制 | 排序能力变化会影响召回结果 |
| 文档解析 | 独立监控任务失败率 | 解析故障不会被语言模型渠道解决 |
尤其不要在知识库已经完成向量化后,直接把 Embedding 渠道映射到另一种模型。更换索引模型通常应重新生成向量,否则可能出现“接口可调用,但检索相关度下降”的隐性故障。
对于更完整的跨渠道熔断设计,可结合大模型 API 多云容灾主备切换方案;如果上游频繁返回限流错误,还应加入429 自动重试、退避与路由降级策略。
如何用 12 次请求完成上线验收?
上线验收不能只点击一次“模型测试”。更可靠的方法是执行 12 次可复现测试,覆盖正常调用、渠道禁用、错误密钥和知识库检索四种状态。
| 测试组 | 次数 | 操作 | 合格结果 |
|---|---|---|---|
| 正常调用 | 4 | 两个渠道均启用 | 4 次均返回完整答案,日志可追踪 |
| 禁用主渠道 | 3 | 手动停用高优先级渠道 | 请求仍可由可用渠道完成 |
| 异常配置 | 2 | 在测试渠道使用无效 Key | 日志明确记录 401 或鉴权错误 |
| 知识库问答 | 3 | 提问含明确文档答案的问题 | 引用内容正确,切换渠道后语义不漂移 |
该验收矩阵共 12 次请求、4 类故障场景、5 个观察指标:成功率、首字响应时间、总耗时、错误码和引用一致性。由于延迟取决于部署地区、文档长度与上游模型,不应套用统一毫秒数;生产验收建议以“12 次无应用级中断、错误可定位、引用结果稳定”为最低通过条件。
FastGPT 还提供已启用模型的周期性健康探测、48 小时状态记录与 Webhook 告警。探测首次失败后最多自动重试三次,连续四次失败才会判为异常,可减少瞬时网络波动造成的误报。(doc.fastgpt.io)
常见配置错误如何排查?
Base URL 返回 404 怎么办?
先确认填写的是服务根地址而非完整聊天接口。部分兼容接口要求在 Base URL 后保留 /v1;FastGPT OpenAPI 文档也提示,部分 SDK 遇到 404 时需要补充该路径。(doc.fastgpt.io)
为什么新增渠道后找不到模型?
模型渠道只能选择模型配置中已经存在的模型。如果下拉列表没有目标模型,应先在“模型配置”中增加自定义模型,再回到渠道页面绑定。(doc.fastgpt.cn)
为什么备用渠道没有接管请求?
依次检查备用渠道是否启用、是否包含相同模型 ID、模型映射是否正确,以及 API Key 是否具备目标模型权限。随后查看调用日志中的请求地址、耗时和错误信息。
可以让不同能力的模型共用一个 ID 吗?
技术上可以映射,但不建议用于生产知识库。若主渠道支持工具调用而备用渠道不支持,切换后工作流可能失败。更稳妥的方式是按能力建立 kb-chat-basic、kb-chat-tools 等独立模型 ID。
FastGPT 与 Dify 的第三方接口配置相同吗?
两者都可对接兼容接口,但模型注册、凭证管理和工作流引用方式不同。需要同时维护两套知识库平台时,可参考Dify 第三方大模型接口配置教程,统一规划 Base URL、模型别名和密钥轮换规则。
配置完成后的运维清单
开源知识库FastGPT配置多渠道负载均衡API后,应把渠道配置纳入持续运维,而不是一次性交付:
- 每个模型 ID 至少保留一个经过验证的备用渠道;
- 密钥按渠道独立管理,避免多个渠道共用同一凭证;
- 每周检查调用日志中的 401、404、429 和超时错误;
- 模型版本变更前验证上下文、流式输出及工具调用能力;
- Embedding 模型变更必须安排重新向量化评估;
- 开启健康探测,并把异常与恢复事件接入告警系统;
- 对敏感知识库核验数据存储区域、日志策略和供应商授权。
真正稳定的架构并非渠道越多越好,而是做到模型 ID 统一、能力边界一致、故障可以复现、切换结果可以验收。这样才能让 FastGPT 的知识库应用在上游变化时保持较低的迁移成本。