作者:nTokenX|发布日期:2026-10-04|更新日期:2026-10-04
大模型接口调用错误码429自动重试策略不能只是捕获异常后立即重发。生产环境应先判断限流原因,再按 Retry-After、指数退避、随机抖动、重试预算和路由降级的顺序处理,否则重试本身可能放大流量峰值。
大模型 API 为什么会返回 429?
HTTP 429 表示当前请求因速率、Token、并发或账户配额限制而未被接受,但并非所有 429 都适合自动重试。 临时限流可以等待恢复,余额、消费上限或长期配额耗尽则需要人工处理。
常见原因包括:
| 429 类型 | 识别信号 | 正确动作 |
|---|---|---|
| 请求速率超限 | RPM、QPS 剩余量归零 | 延迟后重试并降低发送速度 |
| Token 速率超限 | TPM、输入或输出 Token 超限 | 缩短上下文并限制并发 |
| 突发流量限制 | 平均用量正常,但瞬时请求激增 | 平滑流量,加入随机抖动 |
| 并发槽位耗尽 | 长连接或流式请求过多 | 排队,不要立即重放 |
| 账户配额或消费上限 | 错误体提示额度、余额或账单问题 | 停止重试并告警 |
OpenAI 明确指出,429 既可能是临时速率限制,也可能来自余额或使用上限;Anthropic 的速率限制则按请求、输入 Token 和输出 Token 等维度计算。(developers.openai.com)
收到 429 后应该按什么顺序处理?
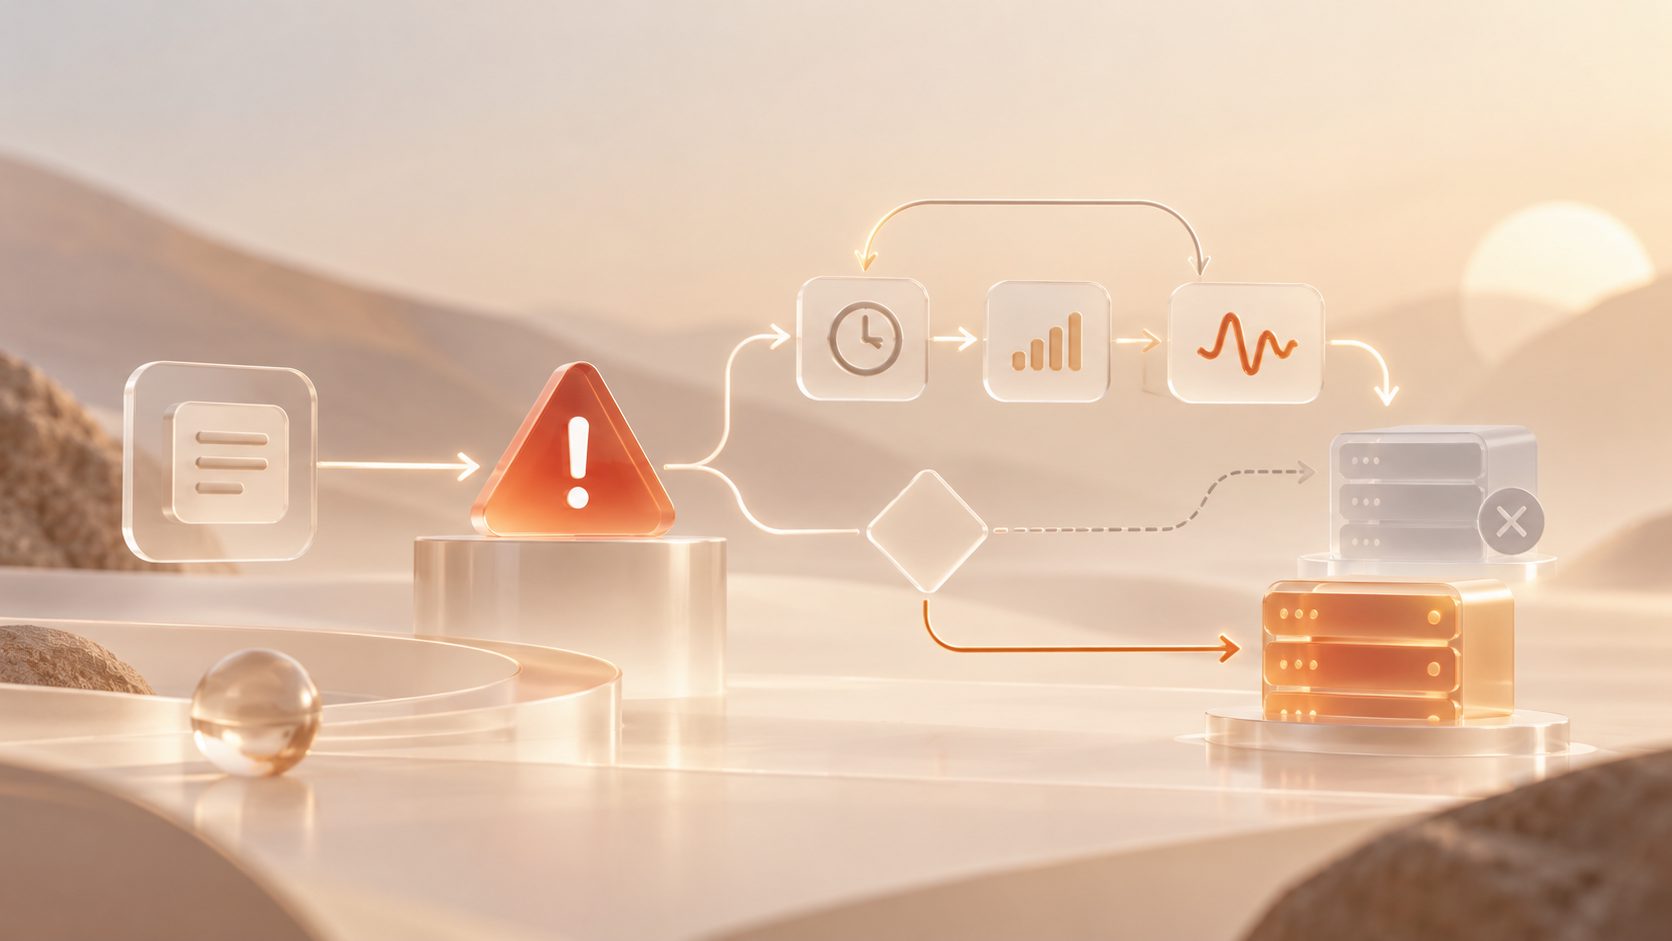
正确流程是:解析错误类型,优先遵守服务端等待时间,再执行带抖动的截断指数退避;超过总时限后进入队列、切换路由或快速失败。
- 读取 HTTP 状态码、错误码和错误消息。
- 检查
Retry-After及限流重置响应头。 - 排除余额不足、消费上限和永久配额问题。
- 确认请求是否可安全重试,尤其是工具调用与写操作。
- 没有有效等待时间时,使用指数退避加随机抖动。
- 达到次数或总时间上限后停止重试。
- 将任务放回队列,或切换已通过兼容性验证的模型通道。
OpenAI 和 Anthropic 都建议遵守 Retry-After;Google Gemini 文档则建议对可恢复的 429、408 与部分 5xx 使用指数退避,并设置最大重试次数。(developers.openai.com)
指数退避和随机抖动如何计算?
推荐使用全抖动截断退避:每轮先计算指数上限,再从零到该上限之间随机等待。 它比固定间隔更能分散并发客户端,避免恢复时再次形成“惊群”。
退避上限 = min(最大延迟, 基础延迟 × 2^重试次数)
实际等待 = random(0, 退避上限)
以基础延迟 500 毫秒、最多重试 4 次为例:
| 重试轮次 | 无抖动等待 | 全抖动范围 |
|---|---|---|
| 第 1 次 | 0.5 秒 | 0~0.5 秒 |
| 第 2 次 | 1 秒 | 0~1 秒 |
| 第 3 次 | 2 秒 | 0~2 秒 |
| 第 4 次 | 4 秒 | 0~4 秒 |
四轮无抖动累计等待为 7.5 秒,全抖动的理论平均累计等待为 3.75 秒。若 1,000 个客户端同时失败并固定等待 1 秒,它们会再次同时发送 1,000 个请求;首轮采用 0~0.5 秒全抖动后,按 100 毫秒时间桶演算,平均约有 200 个请求落入每个桶,峰值压力被明显摊开。这是参数化容量演算,不代表特定模型厂商的实测性能。
TypeScript 如何实现可控的 429 自动重试?
生产代码至少要同时限制重试次数、单次延迟和总截止时间,并避免与 SDK 内置重试叠加。 否则客户端重试三次、SDK 再重试三次,最坏可能扩张为多层重复请求。
const sleep = (ms: number) =>
  new Promise(resolve => setTimeout(resolve, ms));

async function callWithRetry<T>(
  send: () => Promise<T>,
  maxAttempts = 4,
  deadlineMs = 12_000
): Promise<T> {
  const startedAt = Date.now();

  for (let attempt = 0; attempt < maxAttempts; attempt++) {
    try {
      return await send();
    } catch (error: any) {
      const status = error?.status;
      const code = error?.code;
      const retryAfter = Number(error?.headers?.["retry-after"]);

      const temporary429 =
        status === 429 &&
        !["credit_balance_exhausted", "quota_exceeded"]
          .includes(code);

      if (!temporary429 || attempt === maxAttempts - 1) throw error;

      const exponentialCap = Math.min(8000, 500 * 2 ** attempt);
      const fallbackDelay = Math.random() * exponentialCap;
      const delayMs = Number.isFinite(retryAfter)
        ? retryAfter * 1000 + Math.random() * 250
        : fallbackDelay;

      if (Date.now() - startedAt + delayMs > deadlineMs) throw error;
      await sleep(delayMs);
    }
  }

  throw new Error("重试预算已耗尽");
}
接入前还应核对所用 SDK 的默认行为。OpenAI 官方文档提示,其 SDK 会自动重试符合条件的 429 和 503,因此应用层必须把内置重试计入总预算。(developers.openai.com)
为什么只做自动重试仍然不够?
429 通常是容量管理问题,而不只是异常处理问题。 如果入口没有并发限制,大量请求会在失败、休眠和再次失败之间循环,增加延迟并持续消耗速率窗口。
建议建立四层防线:
- 入口层: 使用令牌桶或信号量限制并发,按租户隔离配额。
- 执行层: 预估输入与最大输出 Token,避免单个请求占满 TPM。
- 重试层: 设置次数、截止时间和重试流量占比。
- 路由层: 连续触发阈值后熔断当前通道,转入队列或备用模型。
多租户应用可参考多租户 SaaS 大模型配额隔离方案,避免单个客户的突发任务耗尽共享额度。涉及跨通道恢复时,还应配合大模型 API 多云容灾、熔断与自动降级方案,而不是无限延长重试链。
多模型 API 网关如何降低 429 影响?
统一网关的价值不是无条件重放请求,而是集中完成限流观测、并发整形、通道健康检查和受控降级。 路由切换前必须确认模型能力、上下文长度、工具协议和输出格式兼容。
nTokenX 允许用户申请一个 API Key,调用 GPT、Claude、Gemini、Grok 等多个模型。工程团队可在统一接入层为不同业务设置候选模型,但仍需自行定义熔断阈值、超时预算和降级边界。
选择此类服务时,应区分正规 API 聚合网关与第三方模型中转,重点核验授权方式、响应头透传、日志脱敏和数据安全。自建与托管方案的取舍可结合OneAPI 与商业 AI 网关稳定性对比评估。
哪些请求不应该自动重试?
认证失败、参数错误、余额耗尽以及已产生外部副作用的请求,不应仅凭状态码反复执行。 流式响应已经输出部分内容时,也不能把第二次生成直接拼接到第一次结果之后。
以下场景应停止或谨慎重试:
400参数或请求结构错误;401、403鉴权及权限错误;- 明确的余额、账单或永久配额错误;
- 已执行支付、发信、写库等工具调用;
- SSE 流已经返回部分文本后中断;
- 用户已经取消请求或业务截止时间已过。
对于可能产生副作用的操作,应设置幂等键,并将“模型生成”和“工具执行”拆成两个阶段。Google Cloud 的重试指南同样强调,非幂等操作被重复执行可能产生额外副作用。(docs.cloud.google.com)
常见问题
429 出现后等待 1 秒再重试可以吗?
可以作为低并发测试的临时方案,但不适合生产环境。固定等待会使大量实例同时恢复请求,应优先读取 Retry-After,缺失时使用带随机抖动的指数退避。
自动重试设置几次比较合适?
交互请求通常可从 2~4 次开始,并同时设置 8~15 秒总截止时间;离线任务可以采用更长预算。最终参数应根据业务延迟目标、供应商限制和任务是否可排队确定。
换一个 API Key 能解决 429 吗?
不一定。部分厂商按项目、组织、账户或模型统一计量,多把 Key 可能仍共享同一限额。应先读取错误信息与限流响应头,不要把轮换 Key 当作默认方案。
429 是否应该立即切换模型?
不应在首次 429 后立即切换。短暂限流可先退避;只有连续失败、预计等待超过用户截止时间,且备用模型通过能力与安全验证时,才适合降级路由。
结论
大模型接口调用错误码429自动重试策略的核心,是控制重试流量,而不是追求更多重试次数。 先区分临时限流与永久额度问题,再依次应用 Retry-After、全抖动指数退避、并发整形、总重试预算和熔断路由,才能在提高成功率的同时避免惊群与重复执行。