作者:nTokenX|发布日期:2026-09-29|更新日期:2026-09-29
多租户SaaS接入大模型配额隔离方案的核心,不是简单给每个客户分配一个 API Key,而是把租户身份、请求限流、Token 用量、成本归属和模型路由绑定在同一条请求链路中,避免“一个租户突发调用,拖慢所有客户”的问题。
什么是多租户大模型配额隔离?
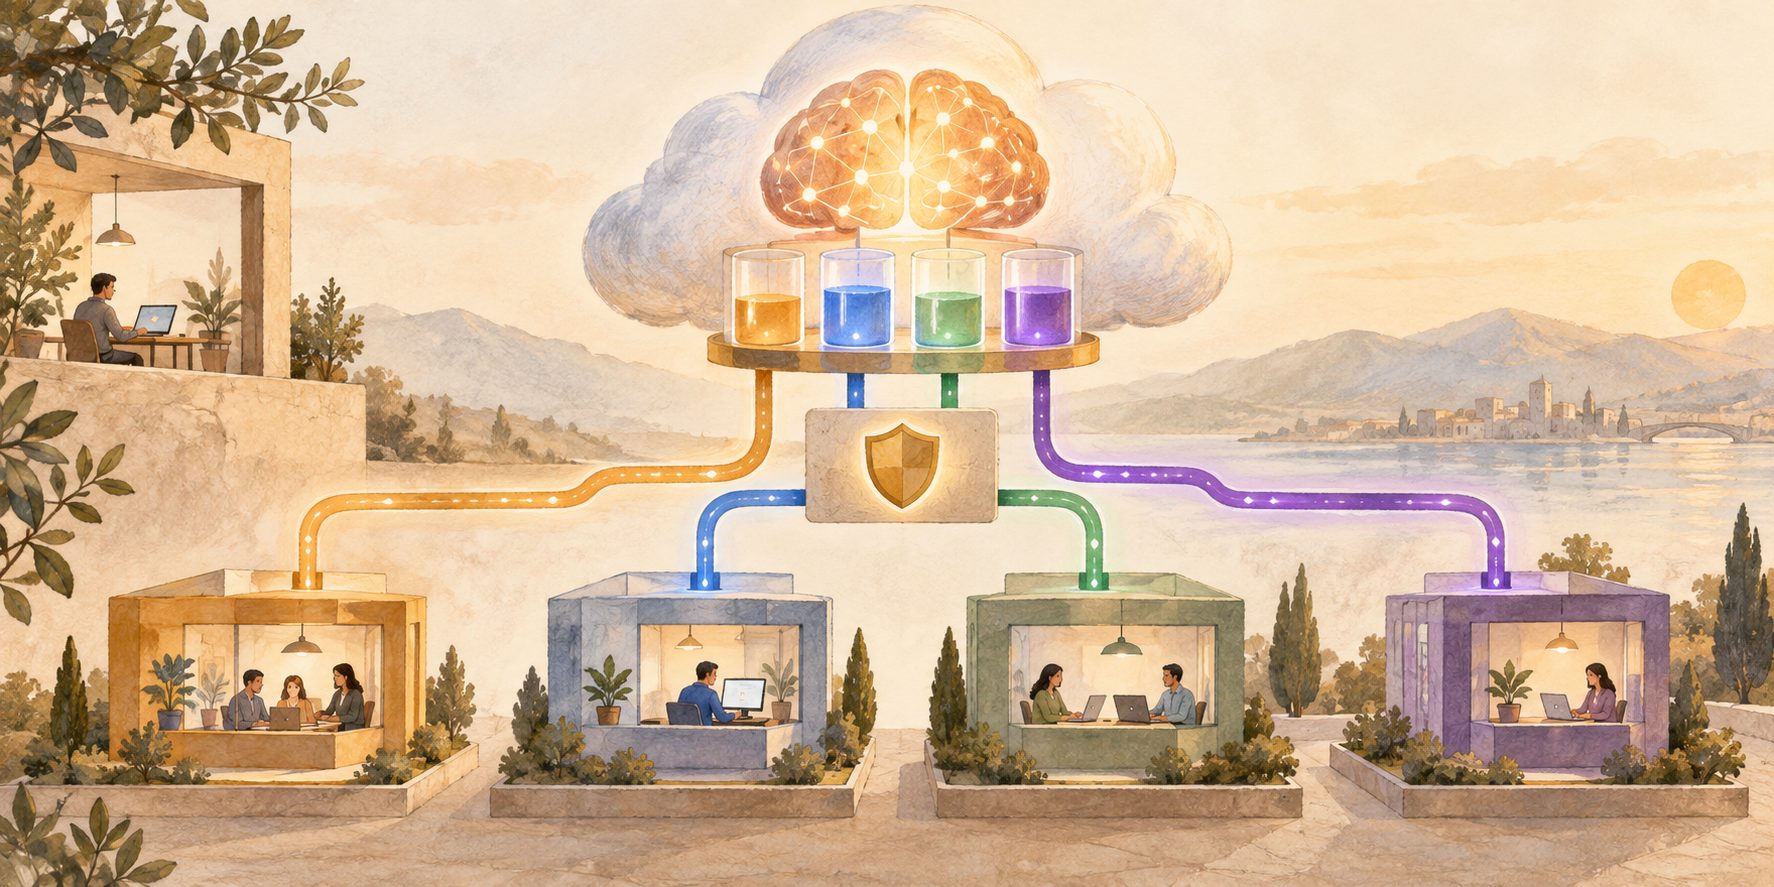
多租户大模型配额隔离,是指同一套 SaaS 应用服务多个客户时,为每个租户建立独立的访问边界、速率限制和用量账本,同时共享底层模型资源。租户 ID 应从认证入口开始,贯穿提示词、检索、工具调用、缓存、日志与计费链路,而不能只停留在数据库字段层面。(theeazyware.com)
与传统 SaaS 相比,大模型请求具有输入长度不固定、输出不可预测、模型单价不同、上下文可能持续增长等特点。因此,单纯按照请求次数计费或限流,往往无法准确反映真实消耗。
更稳妥的做法,是同时管理三类配额:
- 请求配额:每分钟请求数、并发请求数;
- Token 配额:输入 Token、输出 Token、总 Token;
- 预算配额:日预算、月预算、项目预算或租户合同预算。
为什么共享一个模型账号会产生“噪声邻居”?
在没有租户级限流时,批量任务、自动化工作流或异常重试可能快速消耗上游 TPM、RPM 或账户预算。其他租户即使业务正常,也可能遭遇排队、429 限流或响应延迟上升。AWS 的多租户示例表明,为不同消费者设置独立请求速率后,低配额租户被限制不会直接影响其他租户的成功率。(aws.amazon.com)
实践中常见的错误有三种:
- 只按 API Key 限流:多个客户共用一个后端 Key,无法识别真实租户。
- 只按请求次数计费:一次短问答和一次长上下文生成被视为同等消耗。
- 只限制入口,不限制重试:业务服务、队列消费者和故障转移模块重复放大请求。
因此,隔离应至少分为“身份隔离、流量隔离、成本隔离、数据隔离”四个层次。
一套可落地的四层隔离框架
第一层:身份与密钥隔离
用户登录 SaaS 后,系统应为其建立稳定的 tenant_id,并将该字段写入请求上下文。对外暴露的应用 Key、项目 Key、成员 Key 应具有不同权限,不能让前端直接持有上游模型厂商密钥。
推荐的请求链路是:
- SaaS 用户请求业务接口;
- 网关验证应用身份与租户归属;
- 根据租户策略检查模型、RPM、TPM 和预算;
- 生成带租户标签的内部请求;
- 调用模型并记录完整用量;
- 将结果、费用和状态写回租户账本。
如果使用统一大模型 API,应用只需对接一个入口,再由后端选择 GPT、Claude、Gemini、Grok 等模型。nTokenX 的定位正是提供一个 API Key 调用多个模型的统一接入方式,但租户级策略仍应在 SaaS 自身的业务层明确维护。
第二层:请求与 Token 配额隔离
配额应采用“硬限制 + 软预警”组合,而不是只设置一个总额度。
| 配额维度 | 控制对象 | 适用场景 |
|---|---|---|
| RPM | 每分钟请求数 | 防止短时间突发流量 |
| TPM | 每分钟 Token 数 | 控制长上下文和批量生成 |
| 并发数 | 同时执行的请求数 | 避免单租户占满连接池 |
| 月度 Token | 周期累计用量 | 套餐、合同或内部成本核算 |
| 单请求上限 | 单次最大输入与输出 | 防止异常上下文失控 |
一个实用的判断公式是:
可用请求额度 = min(请求额度剩余、Token额度剩余、预算额度剩余、并发槽位)
只有四项都满足,网关才应放行请求。Azure 的多租户架构建议也强调,可按租户分配 TPM,并记录 Token 使用量以实现精细成本归属。(learn.microsoft.com)
如何设计租户成本账本?
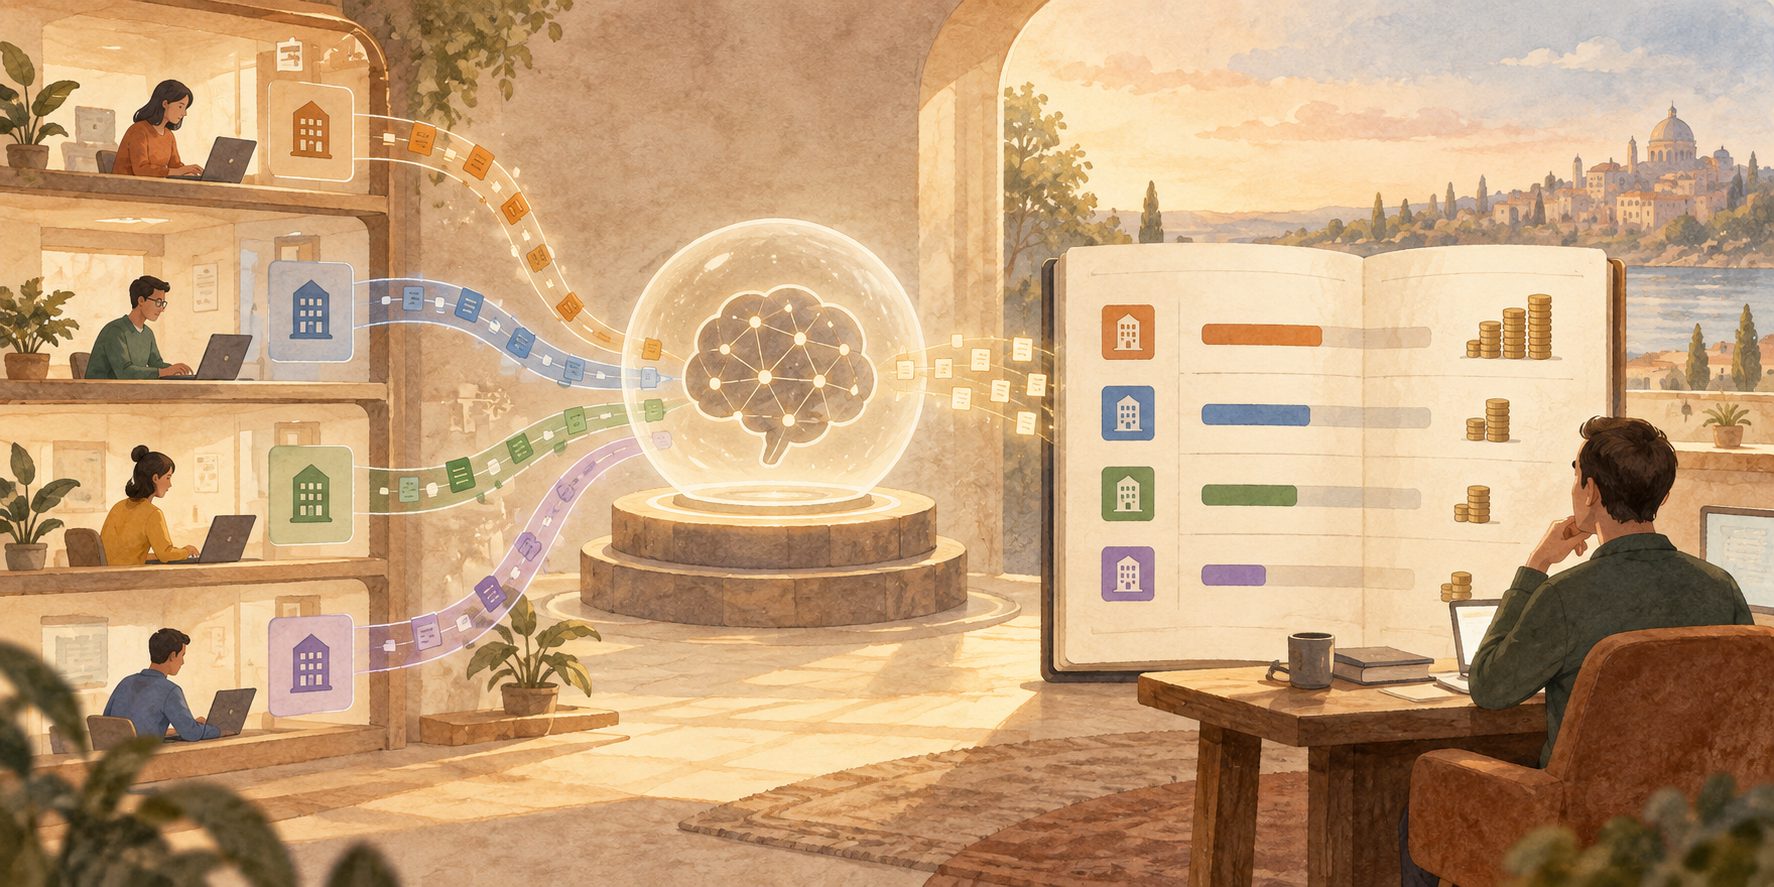
成本账本不能只记录“调用成功”或“调用失败”,至少应保存以下字段:
tenant_id
application_id
model
input_tokens
output_tokens
cached_tokens
request_status
latency_ms
retry_count
created_at
计费计算可采用:
请求成本 =
输入 Token × 输入单价
+ 输出 Token × 输出单价
+ 缓存或工具调用相关成本
不同模型的 Token 单价和上下文能力并不相同,因此建议把“模型路由”和“成本策略”分开管理。业务可以规定:普通问答优先使用通用模型,复杂推理、长文档或高价值任务才允许使用高成本模型。
这里有一个容易遗漏的成本来源:RAG 的检索成本。向量存储、Embedding 调用、重排模型和文档切片都可能被多个租户共享。如果只归集生成 Token,最终会出现某些租户隐性补贴其他租户的情况。相关研究也指出,检索层共享成本经常没有被纳入统一成本归因。(arxiv.org)
模型路由和故障转移如何避免配额穿透?
模型路由不能绕过租户配额。正确顺序应是:
- 校验租户是否有权使用目标模型;
- 检查租户剩余 TPM、预算和并发额度;
- 检查上游模型的实时可用性;
- 按策略选择主模型或备用模型;
- 对重试次数和切换次数单独记录。
例如,租户指定使用某个模型时,系统可以在该模型达到 TPM 限制后返回明确的限流提示;如果合同允许自动切换,则只能切换到租户已授权的备用模型。不能因为主模型失败,就默认将请求转到更高成本或未授权的模型。
多模型统一 API 接入指南中提到,统一接口的价值在于减少不同厂商 SDK、鉴权方式和请求格式的适配工作。对于 SaaS 团队而言,真正需要额外补上的,是租户级权限和成本策略。
应选择哪种隔离强度?
| 方案 | 特点 | 适合场景 | 主要风险 |
|---|---|---|---|
| 共享模型账号 + 业务侧租户标记 | 成本低、上线快 | 内部工具、早期验证 | 额度和故障影响面较大 |
| 统一网关 + 租户虚拟 Key | 便于限流、计费和审计 | 多客户 SaaS | 需要做好网关权限设计 |
| 每租户独立上游账号或项目 | 资源边界清晰 | 高价值、强合规客户 | 运维和配置成本更高 |
| 独立模型实例或专属部署 | 隔离强度最高 | 高并发或定制模型场景 | 资源利用率和维护成本较高 |
多数团队不必一开始就采用物理隔离。更现实的路线是:先使用统一网关完成租户标识、虚拟 Key、Token 账本和限流,再针对高价值客户升级为独立项目或独立上游凭证。Azure 的多租户建议也将共享应用层、特定模型生命周期和更高隔离要求作为不同架构选择条件。(learn.microsoft.com)
nTokenX 在统一接入架构中的位置
nTokenX 可作为多模型 API 的统一接入层:用户申请一个 API Key 后,可以调用 GPT、Claude、Gemini、Grok 等多个模型。对于多租户 SaaS,推荐将 nTokenX 放在业务服务之后,而不是直接把统一 Key 下发给最终客户。
参考架构可以是:
终端用户
  ↓
SaaS 业务层:tenant_id、权限、套餐、预算
  ↓
租户配额服务:RPM、TPM、并发、月度账本
  ↓
统一大模型 API:模型选择与请求转发
  ↓
GPT / Claude / Gemini / Grok 等模型
需要区分两类平台:一类是用户绑定自己的模型厂商 Key,由平台负责统一转发、计费和监控;另一类是平台采购或代理模型额度后再提供统一 API。两类服务在授权、稳定性和数据安全方面可能存在差异,企业接入前应核对服务协议、数据处理方式、日志保留周期和故障切换规则。
关于网关部署与稳定性,可进一步参考自建 OneAPI 与商业 AI 网关的选型对比,再结合自身团队的运维能力决定部署方式。
上线前的验收清单
在正式开放给多个客户前,建议完成以下测试:
- 同一租户并发超限时,是否只限制该租户;
- 一个租户达到 TPM 上限后,其他租户是否仍能正常请求;
- 重试、超时和备用模型调用是否重复计费;
- 每笔请求是否能追溯到租户、应用、模型和时间;
- 缓存命中后,Token 账本是否记录一致;
- 日预算耗尽后,系统是否阻断请求而不是继续透支;
- 日志、提示词、向量检索结果是否发生跨租户读取;
- 租户删除或禁用后,历史 Key 是否立即失效。
这组验收项比单纯测试“接口能否返回结果”更接近生产风险。多租户系统的安全边界必须贯穿认证、路由、检索、日志和计费,而不是依赖某一张数据库表中的 tenant_id。
常见问题
多租户 SaaS 是否必须为每个客户购买独立模型账号?
不一定。早期阶段可以共享上游资源,并通过统一网关实施租户级限流、Token 计量和预算控制。对高敏感、高并发或有专属合规要求的客户,再采用独立项目或独立凭证。
只限制每天调用次数够不够?
通常不够。长上下文任务可能一次消耗大量 Token,因此至少还应限制 TPM、单请求 Token 上限和并发数。
统一 API 是否等于完成了租户隔离?
不是。统一 API 解决的是模型接入和协议适配问题;租户隔离还需要业务侧完成身份映射、权限判断、配额计算、数据分区和审计记录。
如何处理某个租户的突发流量?
先限制该租户的 RPM、TPM 和并发数,再通过队列、优先级和熔断机制保护其他租户。不要让自动重试无限放大流量。